Puntos clave
- Mejora la calidad de los requisitos; requisitos malos → pruebas malas. Siempre.
- La autocuración sin registro es una fábrica silenciosa de defectos a punto de explotar.
- El ML acumula fallos; los humanos aún toman las decisiones.
- La gobernanza escala la IA; sin ella, el 63 % de las iniciativas se estancan en la fase piloto.
- Saltar etapas y la confianza se derrumba en el momento en que la primera decisión de IA provoca la fuga de un defecto.
- Reducir defectos escapados en un 22 % es estrategia; escribir 500 pruebas de IA es vanidad.
Contexto e impacto — la oportunidad
Las organizaciones que adoptan con éxito la IA en aseguramiento de calidad (QA) ven ganancias significativas: ciclos más rápidos, mejor detección de defectos y un ROI medible en meses. Sin embargo, la mayoría se estanca en la etapa piloto. No porque la tecnología falle, sino porque subestimaron la capa de gobernanza. No aclararon qué decisiones corresponden a los humanos y cuáles pueden automatizarse con seguridad.
Hace poco más de un año, si me hubieras dicho que una parte de mi trabajo de diseño de pruebas comenzaría con una conversación en lugar de una hoja de cálculo en blanco, habría sido escéptico. Había asistido a suficientes demos de proveedores donde la herramienta funcionaba perfectamente en una app de tareas pero se desmoronaba ante cualquier sistema similar al nuestro. Así que entré en esta ola de herramientas de IA esperando decepcionarme.
Lo hice, en algunos casos. Pero no en todos. Algunas cosas cambiaron genuinamente cómo paso mi día, y unas pocas le ahorraron al equipo horas reales en el primer mes. Lo que sigue es un relato práctico de dónde la IA generativa y el machine learning están ganando su lugar en la ingeniería de calidad ahora mismo, dónde todavía no se les puede confiar, y cómo sugeriría que un equipo implemente esto sin crear una nueva categoría de defectos que perseguir.
Aquí está el marco. ¿Necesitas ayuda experta? → Consúltanos
El rol está cambiando, no desaparece
Abordemos primero la pregunta que genera ansiedad, porque todos en un equipo de QE están pensando en ello. No, la IA no ha hecho redundantes a los ingenieros de calidad, y no veo que eso cambie pronto. Lo que ha hecho es reducir las partes mecánicas del trabajo; el localizador que tienes que actualizar por cuarta vez esta iteración, los veinte casos límite casi idénticos que escribirías a mano, las doscientas fallas en la pipeline que revisarías un lunes para encontrar las tres que importan.
Ese es el trabajo al que nunca estuve particularmente apegado. Lo que queda es la parte que realmente necesita una persona: decidir qué vale la pena probar, juzgar si el comportamiento que tienes delante es correcto, entender por qué existe un caso límite particular porque recuerdas el incidente que lo creó. Si acaso, el trabajo se ha vuelto más interesante y algo más exigente, porque revisar bien la salida de la IA requiere conocer el dominio a la perfección.
Dónde funciona
Diseño de pruebas y generación de casos
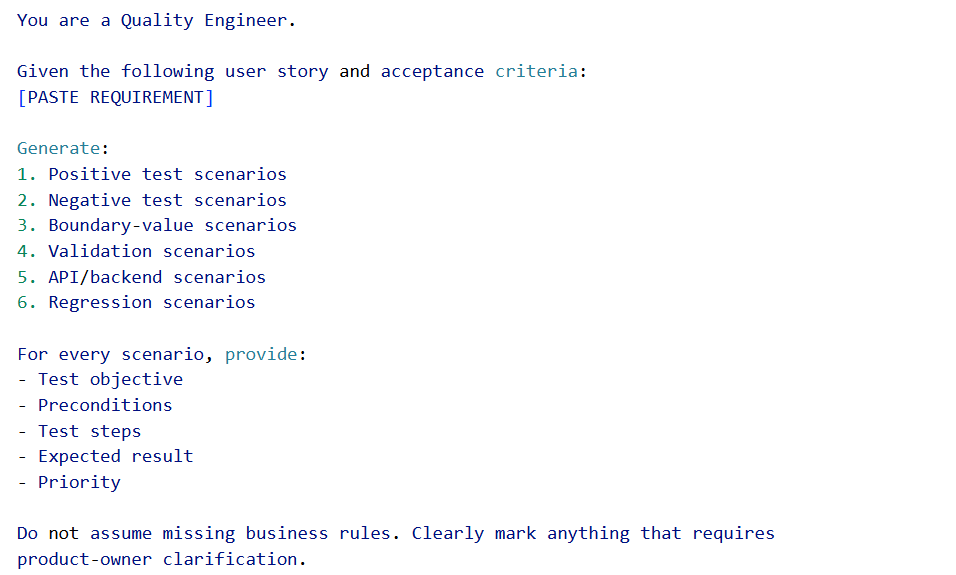
Este fue el que más me sorprendió. Puedo manejar un modelo de lenguaje, una historia de usuario con criterios de aceptación decentes o un contrato API, y obtener de vuelta una variedad de escenarios positivos, negativos y de límite en el tiempo que me toma rellenar mi café. Tal vez un tercio de ellos son cosas que habría pensado de todos modos. Otro tercio vale la pena conservarlo y podría haberme perdido uno o dos bajo presión de tiempo. El resto lo descarto. Es un socio para lluvia de ideas que nunca se cansa y nunca se pone a la defensiva cuando rechazas sus ideas.
El inconveniente, y es grande: esto solo funciona bien cuando los requisitos están bien redactados. Si le das una historia vaga, obtendrás tonterías vagas y confiadas a cambio. La IA amplifica la calidad que ya tienen tus especificaciones. En más de una ocasión, el ejercicio de intentar generar pruebas a partir de una historia reveló que la historia misma estaba insuficientemente especificada, lo cual fue útil por sí mismo.
Ejemplo — Indicación para Generación de Pruebas
Automatización autocorrectiva
Cualquiera que ha mantenido una suite de UI grande sabe que la mayoría de los fallos no son reales. Cambió un localizador, se añadió un div contenedor, alguien renombró una clase CSS. La prueba está en rojo pero la funcionalidad está bien. Los frameworks más recientes ahora identifican elementos con varias señales a la vez; texto visible, rol de accesibilidad, posición, etiquetas cercanas; y corrigen discretamente el localizador cuando el DOM cambia debajo.
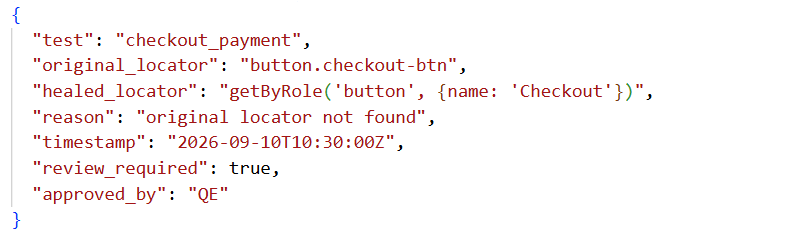
Cuando esto funciona, reduce genuinamente el tiempo de mantenimiento. Pero quiero ser cuidadoso aquí, porque hay un modo de fallo peor que una prueba rota. Si una prueba se "autosana" silenciosamente ante una regresión real, tienes una compilación en verde que oculta un defecto real. Así que la regla en mi equipo es simple: cada acción de autocorrección se registra, aparece en el informe y recibe una revisión humana semanalmente. La autocorrección invisible es una responsabilidad, no una característica.
Ejemplo — Registro de Auditoría de Autocorrección
Triaje de fallos y detección de pruebas inestables
El aprendizaje automático es bueno para detectar patrones en miles de ejecuciones, que es precisamente la naturaleza de este problema. La herramienta agrupa fallos por causa probable y señala pruebas cuyo historial de paso/fallo parece no determinista. En lugar de abrir ochenta fallos, abro los cuatro grupos encontrados y usualmente el problema real está en el primero.
Generación de datos de prueba
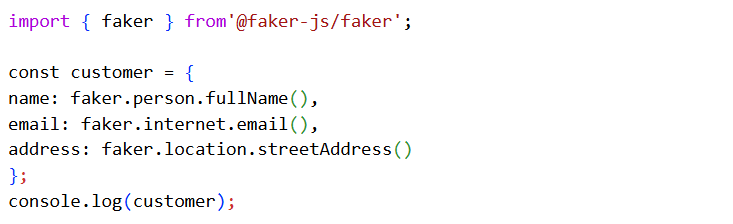
Operamos bajo restricciones de privacidad que hacen inviable usar datos de producción en la mayoría de los escenarios. Los modelos generativos pueden producir registros sintéticos — nombres, direcciones, historiales de transacciones — que siguen distribuciones similares a producción sin información real de clientes. No es perfecto, y aún hay que considerar cuidadosamente la integridad referencial entre tablas, pero es mucho mejor que los elementos mantenidos a mano que antes teníamos a duras penas en marcha.
Ejemplo — Datos Sintéticos para Pruebas
Análisis de brechas de cobertura
En lugar de perseguir un porcentaje de cobertura, que todos saben es un proxy débil, puedo apuntar herramientas de IA a un conjunto de cambios de código y preguntar por qué rutas los tests existentes no pasan. Eso convierte la cobertura de un número a una lista de tareas.
Impacto estimado del ROI: primeros 6 meses
Las siguientes cifras deben considerarse como estimaciones ilustrativas, no como puntos de referencia universales. Los resultados reales dependerán de la línea base del equipo, las herramientas, la complejidad de la aplicación y la madurez de la adopción.
Diseño y mantenimiento de pruebas
- Tiempo por prueba: reducción aproximada del 60 % — de 4 horas a 1.5 horas
- Horas anuales ahorradas: aproximadamente de 320 a 400 horas por ingeniero
Resultados de calidad
- Detección de defectos: +22%
- Evasiones de regresión: -18%
- Estabilidad de compilación: +12%
Velocidad del equipo
- Tiempo de ciclo por función: -25%
- Ciclo de revisión de código: -15%
ROI neto — ejemplo de equipo de QA de 6 personas
- Costo estimado de herramientas: ~$15K/año
- Valor anual estimado: ~$110K+ equivalente a aproximadamente 1 FTE
- Periodo de recuperación estimado: ~1.6 meses
Lo importante no es que cada equipo logre estos números exactos. La pregunta útil es si el equipo puede establecer una línea base y demostrar una mejora medible después de la adopción. Para las organizaciones que buscan validar estas mejoras de rendimiento en condiciones de escala de producción, las pruebas de rendimiento y escalabilidad garantizan que sus mejoras de calidad se mantengan bajo cargas reales.
Modos de fallo críticos
Dónde todavía falla
No quiero que esto parezca una página de ventas, así que aquí está el otro lado honesto.
El problema del oráculo no ha cambiado. La IA puede generar una prueba durante todo el día, pero decidir si el comportamiento que observa es correcto sigue recayendo en una persona o en una especificación en la que realmente confíes. El modelo no sabe qué se supone que debe hacer tu producto; sabe qué texto suele seguir a otro texto.
Las afirmaciones alucinadas son reales y son engañosas. El modelo producirá una afirmación que parece completamente razonable — nombres de métodos correctos, valor esperado plausible — y simplemente está equivocada. Si integras el código de prueba generado sin leer cada afirmación, eventualmente lanzarás una prueba que pasa por la razón equivocada.
La no determinación en las herramientas en sí complica la revisión. Ejecuta el mismo prompt dos veces y puedes obtener código diferente. Eso es incómodo cuando todo tu proceso está basado en cambios revisables y comparables en el control de versiones.
Los límites de contexto significan que la herramienta rara vez entiende todo tu sistema, tus obligaciones de cumplimiento o la historia organizacional detrás de un requisito que parece extraño. Optimiza para el prompt que tiene delante.
Y está la cuestión de los datos. Enviar código propietario o requisitos no publicados a un modelo de terceros puede violar silenciosamente tus propias políticas. Antes de adoptar cualquier cosa, averigua exactamente a dónde van tus entradas y quién puede verlas.
Cómo detectar modos de fallo
Una revisión mensual ligera puede detectar la mayoría de estos problemas sin crear otro proceso para el que nadie tiene tiempo.
Modo de fallo | Revisión rápida |
Problema del oráculo | Elige 5 pruebas. ¿Puedes explicar por qué existe cada afirmación? |
Afirmaciones alucinadas | Verifica los nombres de los métodos y los valores esperados con respecto a la API/requisito real. |
No determinismo | Ejecuta dos veces el mismo prompt. ¿Los resultados son lo suficientemente consistentes para revisar? |
Brechas de contexto | Revisa los escenarios que se pasaron por alto este mes y añade el contexto relevante al siguiente prompt. |
Revisión de sanación | Verifica si alguna prueba sanada posteriormente se asoció con un defecto real. |
Actualidad de datos | Confirma que los datos sintéticos todavía representan los patrones actuales de producción. |
Tiempo: Menos de 30 minutos al mes.
Métrica de éxito: Cero sorpresas inesperadas en producción causadas por una prueba generada o modificada por IA sin revisar.
Manual de implementación
Un camino de implementación que no fracase
Si empezara un equipo desde cero en esto, seguiría este orden y resistiría la tentación de adelantarse.
1. Autoría asistida
La IA redacta casos de prueba y código; un humano revisa todo antes de que se integre.
Por qué empezar aquí: Bajo riesgo, beneficio inmediato y permite al equipo familiarizarse con dónde la herramienta es confiable.
2. Automatización del mantenimiento
Activa localizadores autocorrectivos y detección de pruebas inconsistentes, registrando y revisando cada cambio automatizado según un cronograma.
3. Ejecución inteligente
Agrega selección de pruebas basada en riesgo para que cada commit ejecute el subconjunto más relevante y la suite completa se ejecute cada noche.
4. Analíticas
Permite que la IA resuma las tendencias de calidad y señale riesgos en el lanzamiento, alimentando esa información en la planificación.
Error común
El error que he visto en otros equipos es saltar directamente a la etapa tres antes de que alguien confíe en las herramientas de la etapa uno. Cuando la pipeline toma una mala decisión de selección y se escapa un defecto, la confianza colapsa y toda la iniciativa se detiene.
Qué hacer en su lugar: Gana confianza de forma incremental. Comienza con trabajo asistido por IA, mide los resultados, introduce automatización controlada y solo entonces permite que la IA influya en las decisiones de ejecución.
Gobernanza para insistir en
1. Propiedad del artefacto y flujo de trabajo de revisión
Cada artefacto generado por IA debe tener un propietario humano nombrado.
El flujo de trabajo debe ser:
Generación con IA → Revisión de QE → corrección → aprobación → fusión → monitoreo
El revisor debe seguir siendo responsable de la lógica final de las pruebas, las afirmaciones, las reglas de negocio y las implicaciones de seguridad.
2. Registro de auditoría autocorregible
Cada acción de corrección debe capturar:
- Localizador original
- Nuevo localizador
- Razón de la corrección
- Prueba afectada
- Marca temporal
- Compilación/lanzamiento
- Revisor
- Estado final de aprobación
Una acción de corrección que no pueda explicarse después no debe considerarse una mejora exitosa de la automatización.
3. Estructura de versionado de prompts
Los prompts deben tratarse más como activos de ingeniería que como mensajes temporales de un chat.
Una estructura simple podría ser:
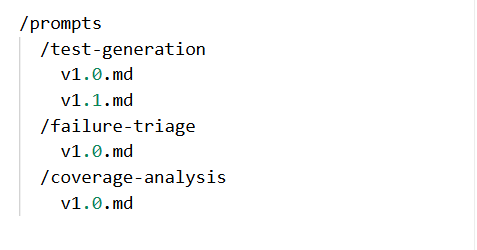
Cada cambio debe documentar qué cambió y por qué.
4. Matriz de clasificación de datos
Tipo de datos | Uso de IA |
Información pública | Generalmente bajo riesgo |
Información interna no sensible | Herramientas empresariales aprobadas |
Código fuente confidencial | Solo modelos/entornos aprobados |
Datos de clientes/PII | Evitar o anonimizar |
Credenciales/secretos de producción | Nunca enviar a modelos de IA |
La política exacta debe seguir siempre los requisitos de seguridad y cumplimiento de la organización.
5. Panel de métricas de éxito
No midas el éxito por la cantidad de prompts o pruebas generadas.
Haz seguimiento de:
- Tiempo de creación de pruebas
- Horas de mantenimiento de automatización
- Tasa de aceptación de pruebas generadas por IA
- Tasa de detección de defectos
- Defectos escapados
- Tiempo del ciclo de regresión
- Tasa de pruebas inestables
- Frecuencia de autocorrección
- Esfuerzo de revisión humana
- Confianza en el lanzamiento
El objetivo es demostrar que la IA está mejorando los resultados de ingeniería y no simplemente creando más artefactos.
Conclusión y próximos pasos
1. Aumento estratégico
El modelo más sólido no es IA versus humanos. Es la IA encargándose de más trabajo mecánico mientras los ingenieros de calidad dedican más tiempo a riesgos, arquitectura, comportamiento empresarial y juicio. Ese cambio hace que la ingeniería de calidad sea más valiosa, no menos.
2. Confianza ganada > Confianza desde el primer día
No esperes que un equipo confíe en la IA solo porque la demostración fue impresionante. Comienza con la autoría asistida, mide los resultados, introduce la automatización controlada y expande solo cuando la evidencia lo respalde.
3. Mide resultados, no actividad
"Se generaron 500 pruebas con IA" es una métrica de vanidad. "Defectos escapados reducidos en un 22%" es una estrategia de calidad.
Los equipos que obtienen valor de la IA tratan cada resultado como un primer borrador, mantienen a una persona responsable de cada decisión y miden resultados reales en vez de contar cuántas pruebas escribió el robot esta semana.
Para las organizaciones que buscan desarrollar esta capacidad a escala, el siguiente paso no es simplemente comprar otra herramienta de IA. Es construir la combinación adecuada de ingeniería de calidad habilitada por IA, automatización, gobernanza y resultados comerciales medibles.
Explora los Servicios de Ingeniería de Calidad de TO THE NEW para aprender más sobre la ingeniería de calidad habilitada por IA y la automatización inteligente de pruebas, o contacta al equipo para una consulta en ingeniería de calidad.
Comienza pequeño, registra todo y deja que la confianza ganada marque el ritmo.