Aperçu
Faire évoluer Apache Airflow au-delà de 1 000 DAGs échoue rarement en raison du seul nombre de DAGs ; l’échec est dû à la complexité des DAGs, à la configuration des workers et aux quotas cloud en aval qui se contredisent. La solution exige des modifications sur trois niveaux : la manière dont les DAGs sont analysés, la façon dont Celery alloue la capacité des workers, et la manière dont l’orchestration respecte les limites des services en aval, comme la concurrence d’AWS Glue.
Points clés
- La complexité du DAG compte davantage que le nombre de DAG ; optimisez l’analyse, pas seulement le nombre de workers.
- Définissez AIRFLOW__CELERY__WORKER_PREFETCH_MULTIPLIER=1 pour éviter que les workers ne monopoliser les tâches de longue durée.
- Politiques de nouvelle tentative séparées : échecs transitoires (sécurisés en nouvelle tentative) vs. échecs de traitement en aval (échec rapide)
- La mise en file d’attente des tâches AWS Glue gère les limites de concurrence ; coordonnez-vous avec l’orchestration Airflow.
- Les chargeurs réduisent la surcharge liée à l’analyse du DAG en pré-calculant les métadonnées en dehors des boucles de l’ordonnanceur.
- La capacité des workers compte moins que la vitesse d’analyse du DAG lorsque les tâches sont en attente
Introduction
Gérer quelques DAGs Apache Airflow diffère considérablement de l’exploitation d’une plateforme d’entreprise comprenant plus de 1 000 DAGs. Apache Airflow sert d’outil d’orchestration pour des pipelines de données complexes impliquant des services tels qu’AWS Glue, Amazon S3 et Amazon Redshift. Lorsque le nombre de DAGs Airflow dépasse ce seuil, des goulets d’étranglement majeurs de scalabilité apparaissent, restant invisibles à plus petite échelle.
Les organisations rencontrent souvent un défi spécifique : des usines de DAG générant plus de 150 tâches dans un seul fichier DAG. À mesure que ces définitions deviennent plus volumineuses et complexes, les temps d’analyse augmentent de manière significative, dégradant le débit du planificateur et la vitesse d’exécution des tâches. Parallèlement, les tâches en attente de travaux externes de longue durée privent les workers Celery, les boucles de relance non optimisées ajoutent une surcharge inutile, et AWS Glue impose des plafonds de concurrence en aval.
Cet article démontre comment l’architecture Apache Airflow peut être optimisée à travers trois couches distinctes : l’analyse des DAG, l’exécution Celery et les quotas cloud en aval.
Pourquoi l’analyse DAG crée-t-elle un goulet d’étranglement dans le planificateur Airflow ?
Les pipelines de données construits avec Apache Airflow suivent des schémas architecturaux prévisibles :
Systèmes sources → Amazon S3 → Apache Airflow → AWS Glue → Amazon Redshift
Bien qu’un environnement puisse héberger plus de 1 000 DAG, le seul nombre de DAG ne représente qu’une partie du problème. Certaines usines de DAG dynamiques génèrent plus de 150 tâches par fichier DAG, créant des délais d’analyse qui se répercutent dans tout le système.
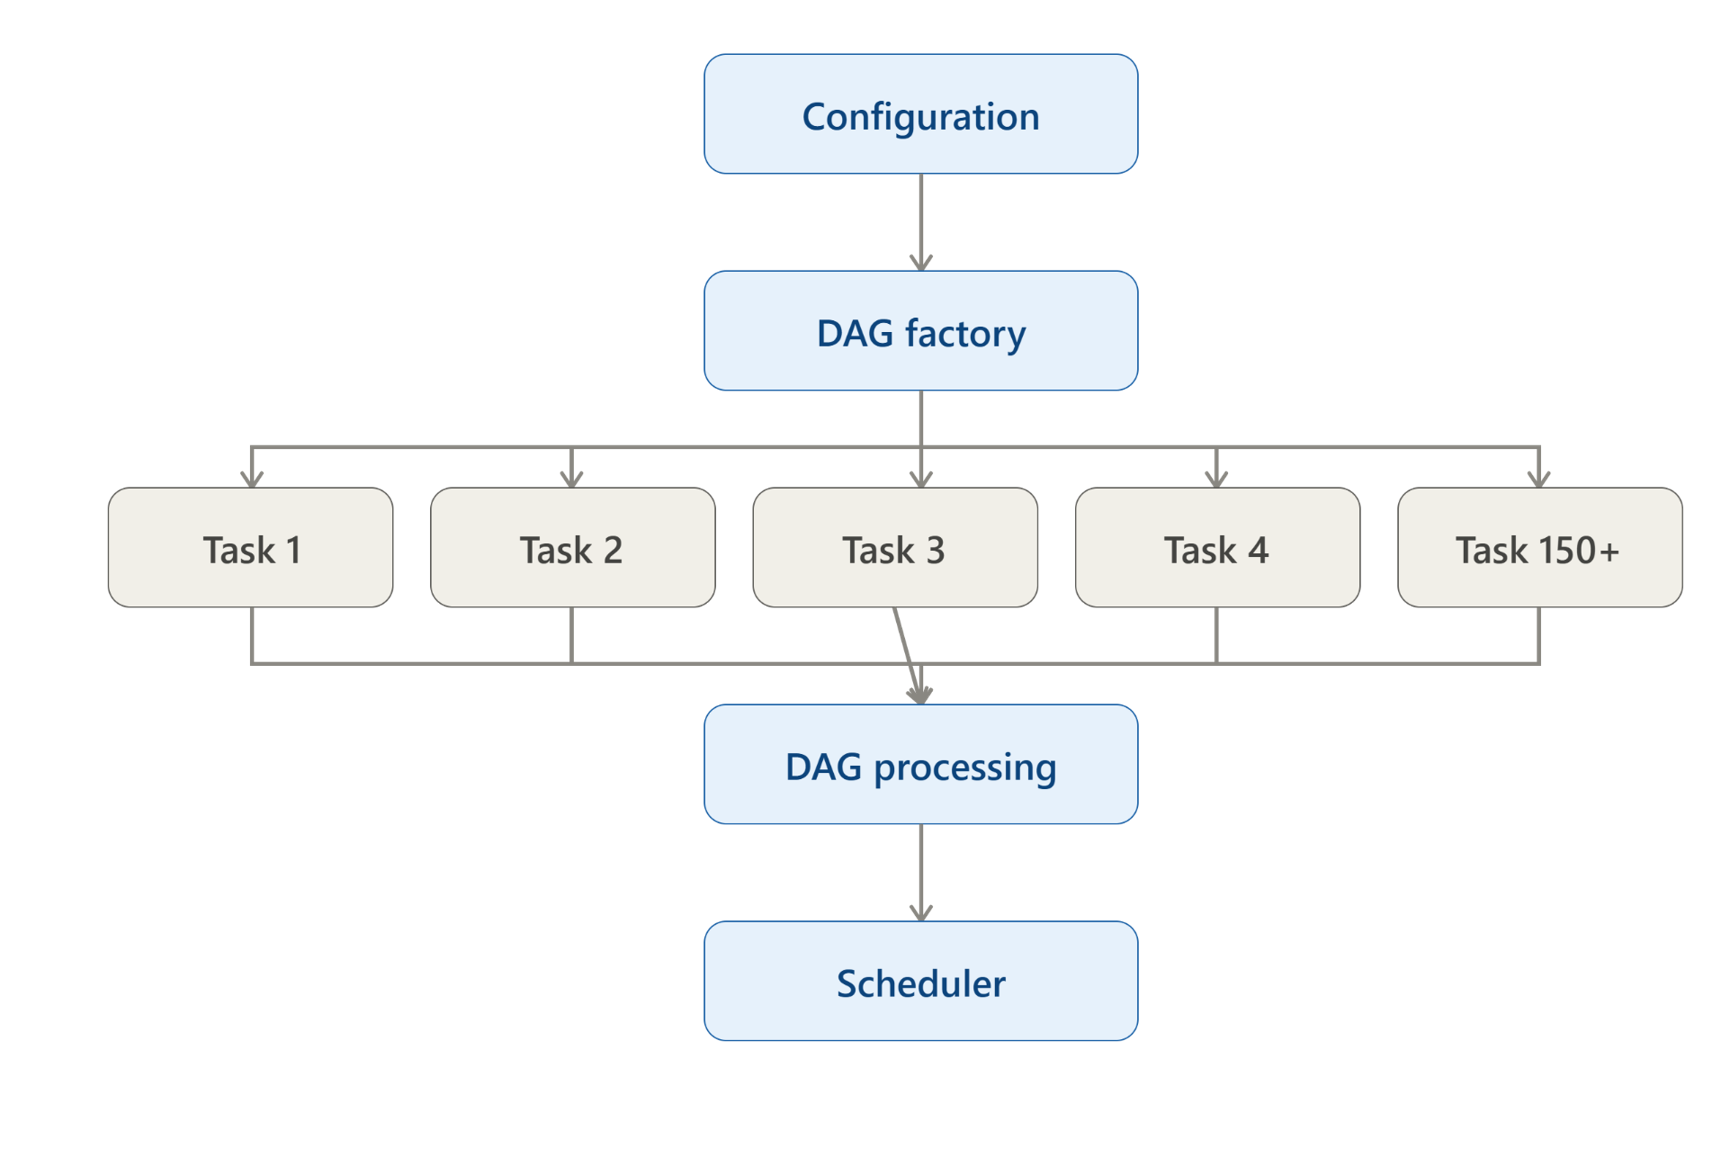
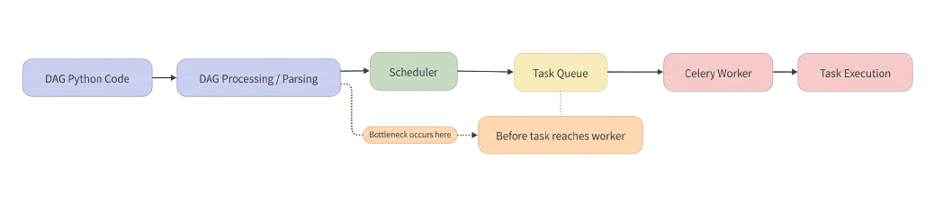
Pour découvrir et actualiser les plannings, Apache Airflow exécute en continu le code Python de haut niveau de chaque fichier DAG. Cette charge de traitement du parsing réside exclusivement sur le chemin du processeur DAG et du planificateur ; elle n’affecte pas les workers Celery. Cette contrainte architecturale signifie que les retards de parsing des DAG affectent directement la performance globale de la plateforme.
Officiel Bonnes pratiques Airflowinsister sur le maintien d’un code DAG de premier niveau léger pour cette raison précise : la vitesse d’analyse impacte directement la performance de l’ordonnanceur et la capacité de déploiement des DAGs Airflow à grande échelle.
La distinction essentielle : Ce travail de parsing s’effectue avant qu’une tâche n’atteigne un worker Celery. Ce délai crée un goulot d’étranglement dans la planification, totalement indépendant de la capacité d’exécution des workers.
Ajouter plus de workers Celery résout-il les problèmes de montée en charge d’Airflow ?
La réaction initiale aux retards de tâches consiste généralement à augmenter l’infrastructure des travailleurs. Si les tâches font la queue dans le broker, ajouter plus de workers Celery semble être la solution évidente. Cependant, cette approche traite les symptômes et non les causes profondes.
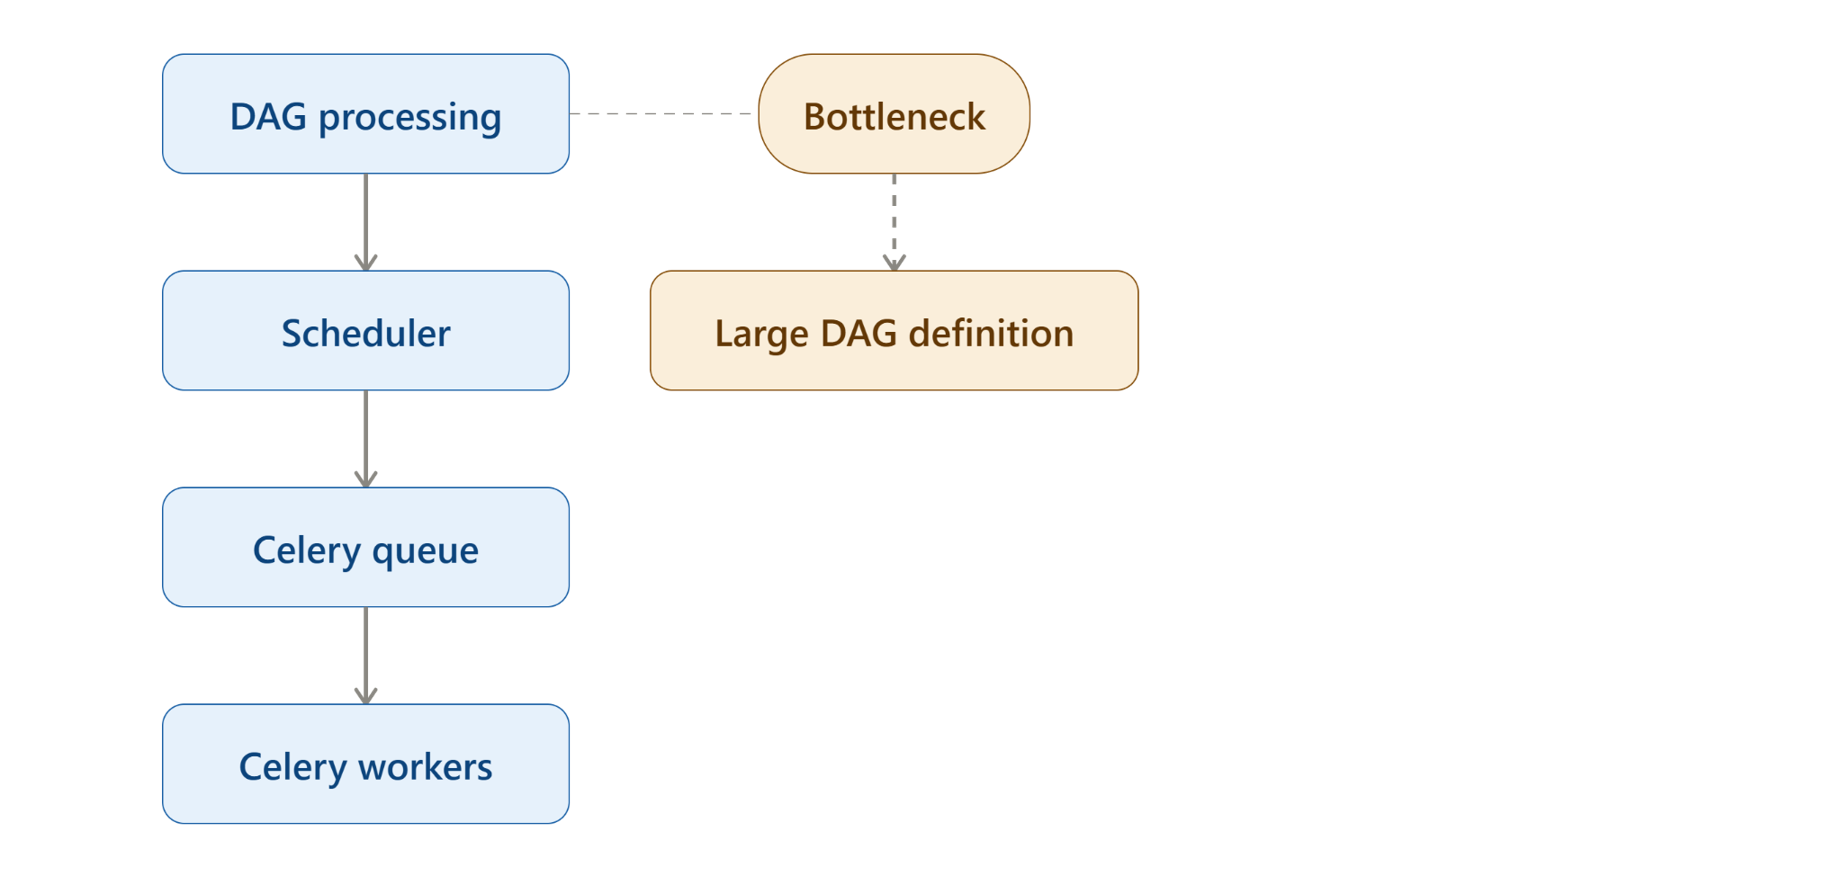
Les workers ne fournissent une capacité d’exécution qu’après qu’une tâche ait été analysée, planifiée et placée dans la file d’attente du broker. Lors des cycles d’analyse intensifs, des workers Celery supplémentaires restent inactifs tandis que le scheduler peine à gérer des définitions de DAG alourdies. Le goulot d’étranglement se situe en amont du déploiement des workers.
Cette prise de conscience exige une approche différente, repensant la génération de DAG elle-même plutôt que d’ajouter de l’infrastructure. La solution s’aligne sur les recommandations d’Airflow concernant réduction de la complexité des DAGet optimiser Traitement des fichiers DAG.
Comment réduire la surcharge de l’analyse des DAG à grande échelle ?
Pour éliminer la surcharge de parsing au niveau supérieur, les Loaders offrent la solution architecturale. Auparavant, les DAG Factories géraient à la fois la préparation des métadonnées et la construction du DAG à chaque cycle de parsing, ce qui entraînait un calcul redondant à chaque actualisation du planificateur.
Avant les chargeurs :
DAG Factory → Charger la configuration → Analyser la configuration → Préparer les informations → Créer des tâches → Construire les dépendances → Définition de DAG volumineux → Traitement du DAG
L'amélioration architecturale :Les chargeurs s’exécutent indépendamment en dehors de la boucle d’analyse du planificateur pour pré-calculer les métadonnées, laissant aux fichiers DAG la tâche de n’effectuer que la déclaration pure du graphe des tâches. Cette dissociation des responsabilités représente un changement fondamental dans l’architecture d’Apache Airflow pour les déploiements en entreprise.
Après les chargeurs :
Configuration → Loader → Informations préparées → Usine DAG → Créer DAG → Créer des tâches → Construire les dépendances → Traitement DAG
Le principal enseignement : Préparez tout ce qui est possible en dehors du processeur DAG, et concentrez les définitions DAG uniquement sur la définition des dépendances des tâches. Cela réduit considérablement les délais d’analyse des DAG.
Comment configurer Celery pour des tâches externes de longue durée ?
L’optimisation du parsing du DAG ne traite qu’une moitié du défi de montée en charge. Lors de l’exécution, un goulot d’étranglement différent apparaît : les tâches qui déclenchent des jobs externes AWS Glue et attendent leur achèvement. La configuration de l’exécuteur Celery devient alors cruciale.
Une tâche en attente d’une exécution distante de Glue réalise un calcul local minimal mais occupe toujours un slot actif de worker Celery. À grande échelle (plus de 1 000 DAGs), des dizaines de tâches en attente simultanément épuisent la capacité des workers, créant une famine artificielle en ressources.
Airflow → Démarrer le Job Glue → Attendre le Job Glue → Glue en cours → Glue terminé → Tâche Airflow terminée
Configuration de Celery pour Enterprise Airflow
AIRFLOW__CELERY__TASK_TIME_LIMIT=18000
AIRFLOW__CELERY__TASK_SOFT_TIME_LIMIT=18000
AIRFLOW__CELERY__WORKER_CONCURRENCY=32
Le paramètre critique : La prélecture des tâches contrôle le nombre de tâches qu’un worker Celery réserve depuis la file d’attente. Par défaut, Celery permet aux workers de précharger plusieurs tâches (worker_concurrency × prefetch_multiplier).
Lorsque les tâches sont de courte durée, cela minimise la latence de distribution. Mais lorsque les tâches sont longues, en attente de services externes, un travailleur qui attend activement les tâches Glue monopolise les tâches en file d’attente.
AIRFLOW__CELERY__WORKER_PREFETCH_MULTIPLIER=1
Par défaut, la prélecture de Celery permet aux workers de réserver un tampon de tâches mises en file d’attente au-delà de celles que leurs processus actifs sont en train d’exécuter (worker_concurrency * prefetch_multiplier). Lorsque les tâches sont courtes, cela minimise la latence de distribution. Mais lorsque les tâches sont longues, un worker occupé à attendre des travaux externes accumule les tâches mises en file, empêchant ainsi d’autres workers inactifs de les exécuter.
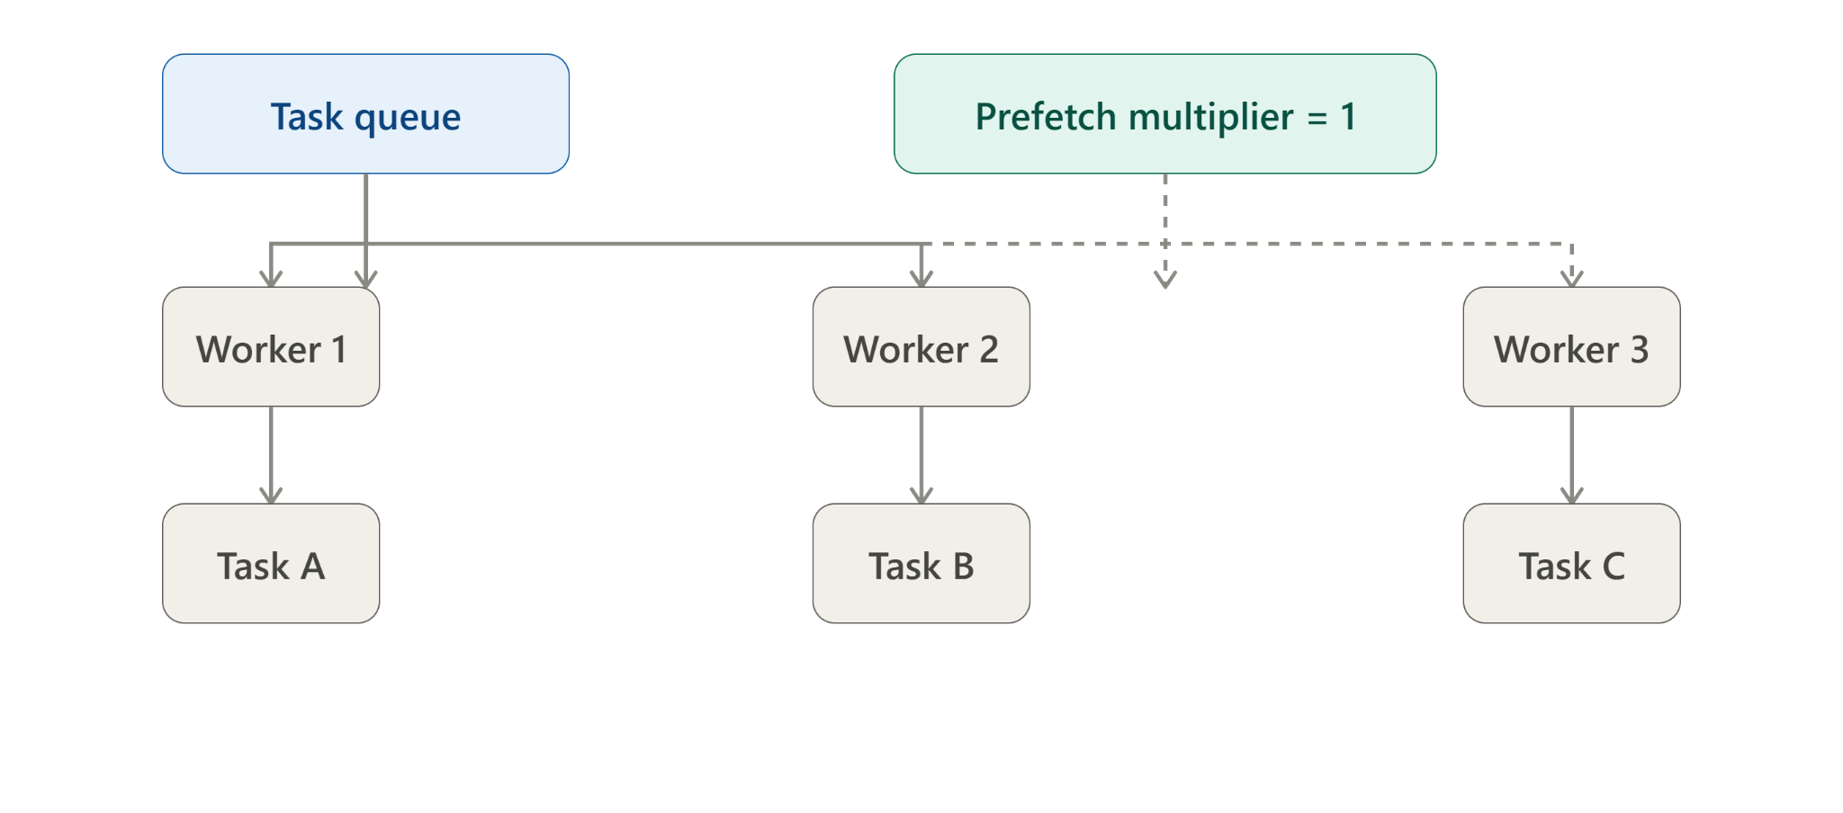
Définir AIRFLOW__CELERY__WORKER_PREFETCH_MULTIPLIER=1 limite chaque processus worker à réserver une seule tâche à la fois. Les tâches restent dans le broker de messages central jusqu’à ce qu’un worker soit réellement prêt à les exécuter. Cela évite une famine artificielle sur l’ensemble du cluster.
Au-delà des paramètres de préchargement, les politiques de nouvelle tentative nécessitent un audit : relancer un capteur qui interroge une exécution Glue échouée consomme simplement un autre créneau de travail sans résoudre le problème sous-jacent. Les tâches surveillant les systèmes en aval devraient échouer rapidement, en réservant les nouvelles tentatives uniquement aux interruptions temporaires du réseau ou au contrôle du débit des API.
Cela correspond à la fois à Conseils de configuration Celery pour Airflowet le document officiel Guide d’optimisation de Celery sur les limites de prélecture.
Cela est particulièrement pertinent lorsque les tâches Airflow passent une grande partie de leur temps d’exécution à attendre les systèmes externes.
Quand faut-il réellement relancer les tâches Airflow ?
La famine des workers n’est pas uniquement causée par les réglages de concurrence. Les stratégies de nouvelle tentative inefficaces y contribuent largement. Retenter une tâche Airflow s’avère inutile si la nouvelle tentative ne peut pas fondamentalement corriger l’échec ; et pourtant, de nombreuses équipes mettent en œuvre cette logique de nouvelle tentative de manière automatique.
Considérez ce scénario : un capteur Airflow surveille un job AWS Glue.
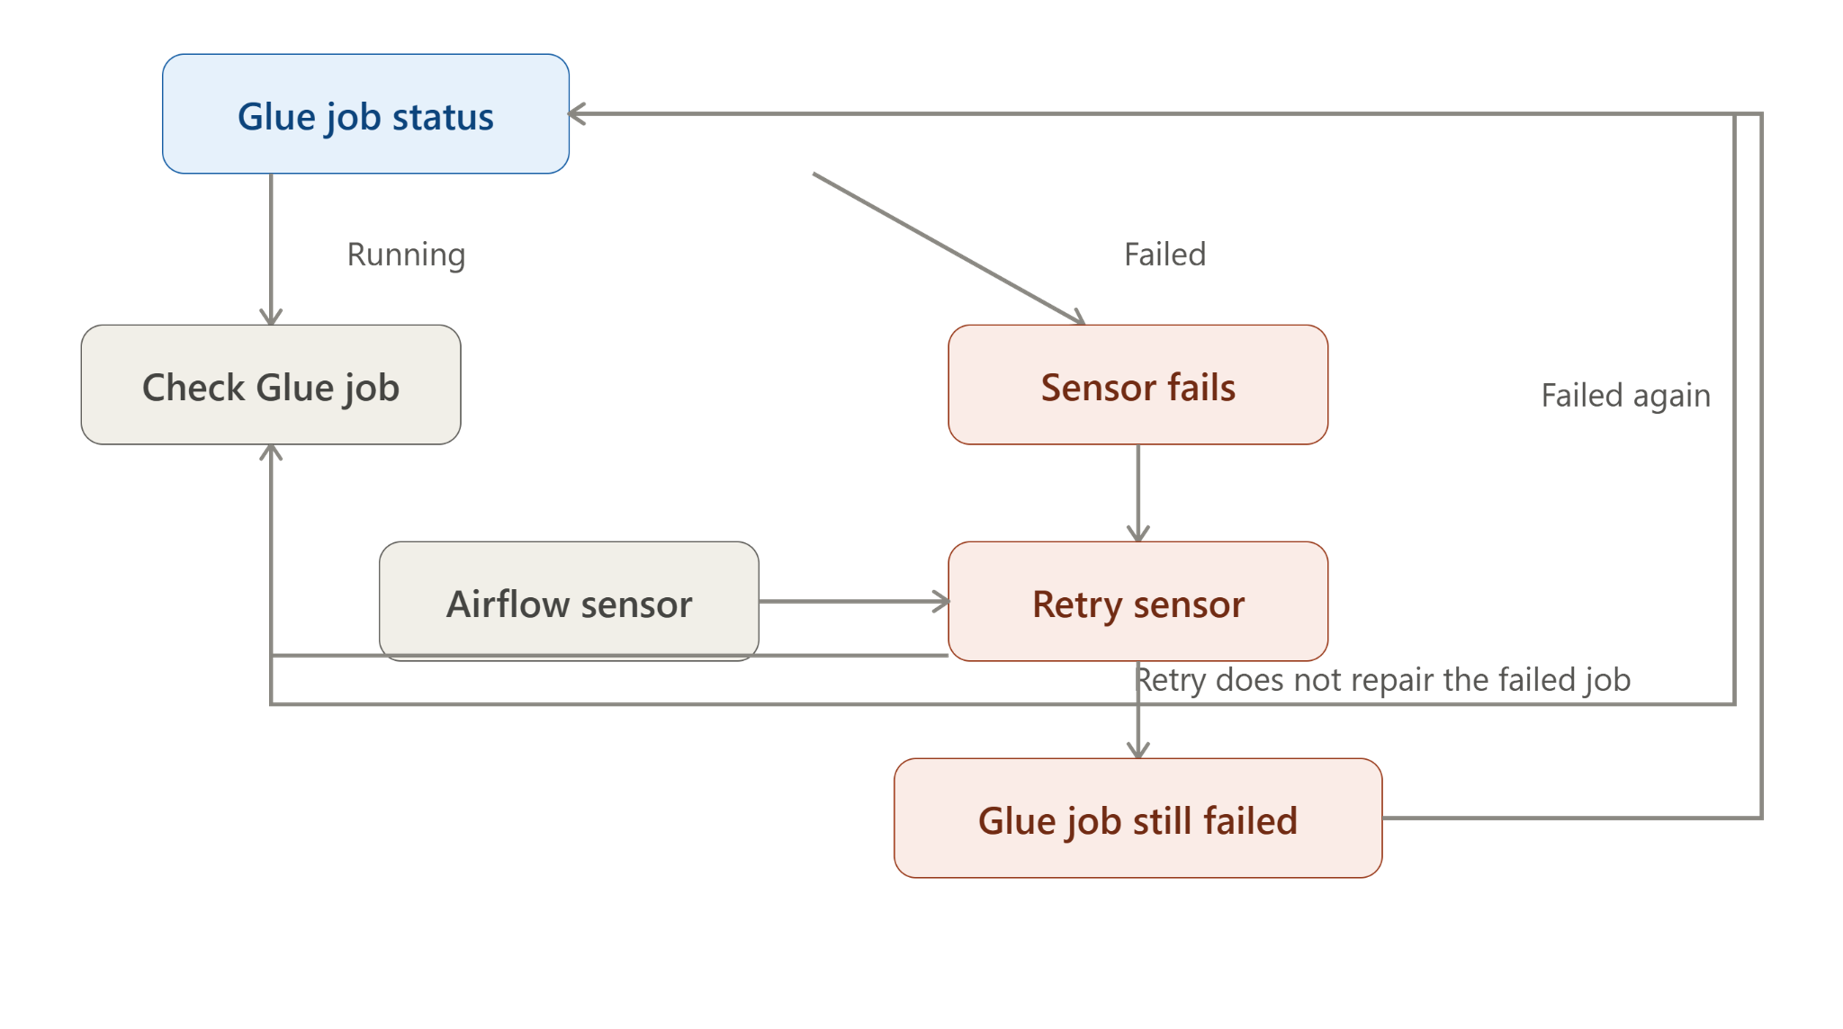
Si ce travail Glue échoue en raison d’erreurs de traitement en aval ou de problèmes de code, relancer le capteur ne redémarre pas le travail Glue. Il se contente de vérifier à nouveau le statut d’échec, consommant des emplacements de travailleurs et des cycles d’orchestrateur sans résoudre le problème sous-jacent.
Les meilleures pratiques distinguent les échecs de tâche en deux catégories :
- Échecs Transitoires (Reprise Sans Risque) :Des perturbations temporaires telles que des coupures réseau, des réinitialisations de connexion ou des limites de taux d'API (délai d'attente API -> Nouvelle tentative -> Succès). Les nouvelles tentatives appartiennent ici.
- Échecs de traitement en aval (Fail-Fast) :Les plantages d’application, les mauvaises entrées ou les erreurs de syntaxe (Échec d’un Glue Job -> Vérifications du capteur -> Échec du capteur). Réessayer une tâche d’observation ne peut pas corriger le problème sous-jacent du job.
Avant de configurer les tentatives sur un opérateur, assurez-vous que la réexécution de la tâche peut réellement résoudre l’erreur. Sinon, échouez immédiatement.
Comment les quotas de service AWS Glue affectent-ils l'orchestration Airflow ?
Même avec une analyse optimisée et une configuration de Celery, les limitations en aval dans le cloud créent de nouveaux goulots d’étranglement. Les DAGs Apache Airflow qui soumettent des tâches à AWS Glue rencontrent des quotas de service au niveau du compte et au niveau des tâches (nombre maximal d’exécutions simultanées, allocations DPU, etc.).
Pour les équipes utilisant Amazon Managed Workflow for Apache Airflow, ces limites de service cloud deviennent des facteurs critiques de mise à l’échelle. Le défi : lorsque Airflow accélère la soumission des pipelines, AWS Glue ne peut pas suivre si les quotas sont atteints.
La solution : Permettre Mise en file d'attente d’exécution de tâche AWS Glueainsi les tâches attendent la capacité au lieu d’échouer purement et simplement.
Conceptuellement :
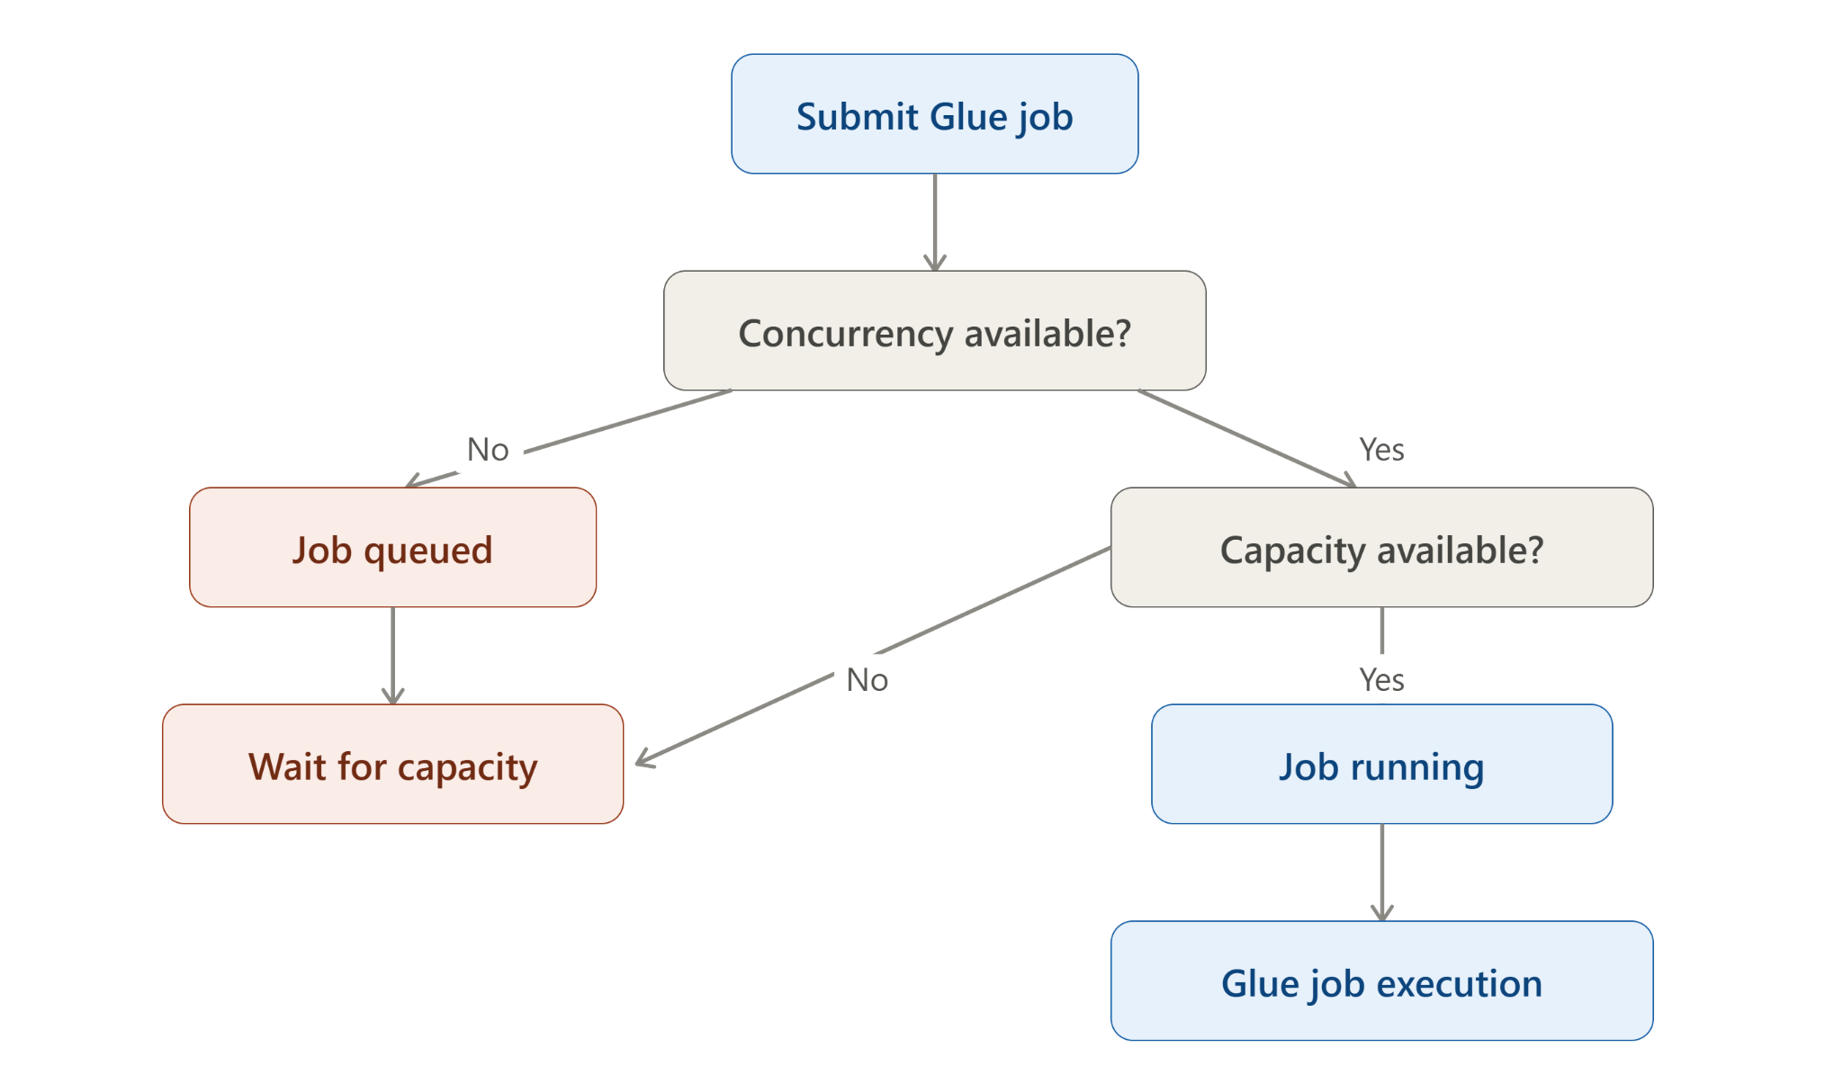
Déclencher des exécutions au-delà de ces seuils provoque des échecs immédiats dus à des erreurs de dépassement de concurrence. Augmenter simplement le parallélisme d’Airflow déplace le goulot d’étranglement en aval au lieu de le résoudre.
Lorsque les limites au niveau du compte ou des tâches sont atteintes, les tâches sont mises en file d’attente dans AWS jusqu’à ce que la capacité se libère. Cette approche architecturale empêche la défaillance du pipeline et permet une gestion fluide de la contre-pression.
Cela clarifie la séparation des responsabilités :
- Airflow gère l'orchestration des pipelines et l'état des dépendances
- Celery gère la capacité d’exécution des tâches
- AWS Glue (ou les services gérés Apache Airflow) gère l’exécution informatique et la montée en charge de l’infrastructure
- La mise en file d’attente des tâches Glue absorbe les pics temporaires de concurrence en aval
Conclusion
Faire évoluer Airflow au-delà de 1 000 DAGs réussit rarement simplement par la montée en charge horizontale.
L'approche d'optimisation à trois niveaux produit des résultats durables :
- La complexité des DAG l’emporte sur le nombre de DAG :Un seul DAG avec 150 tâches impose plus de surcharge d’analyse que des dizaines de DAG simples.
- Les performances d’analyse sont cruciales :Gardez le code DAG de premier niveau minimal en déléguant la préparation des métadonnées aux chargeurs.
- Prévenir l’accumulation excessive de ressources par les travailleurs :Définir AIRFLOW__CELERY__WORKER_PREFETCH_MULTIPLIER=1 lors de l’orchestration de tâches longues.
- Respectez les limites en aval :Coordonner la simultanéité de l'orchestrateur avec les quotas en aval tels que la mise en file d'attente AWS Glue.
Étapes suivantes pour les équipes confrontées à des défis similaires : Les organisations mettant en place des pipelines de données airflow à grande échelle tirent souvent avantage de services de conseil spécialisés en apache airflow. TO THE NEW’s Services d’ingénierie des donnéesaider les équipes à faire évoluer leurs pipelines, optimiser leur architecture Apache Airflow et relever les défis d’intégration cloud en entreprise.