Wichtigste Erkenntnisse: Shift-Right-Testing
- Shift-left ist notwendig, erfasst aber nicht alles. Echte Nutzer, echte Datenmengen und echte Infrastruktur um 2 Uhr morgens verhalten sich anders als Ihre Staging-Umgebung.
- Die Produktion ist Ihre reichhaltigste Quelle für Qualitätsinformationen. Hören Sie auf, sie als Ort zu betrachten, an dem die Tests enden.
- Vorfälle werden zu Regressionstests. Regressionstests werden zu Schutzmaßnahmen. Schließen Sie den Kreis, und derselbe Fehler entkommt nie zweimal.
- Observability-getriebenes Testen beruht auf drei Grundlagen: Instrumentierung, fehlerfreie Kultur und Runbooks. Ohne diese erzeugen Sie nur Lärm.
- Beginnen Sie klein: eine kritische Nutzerreise, ein SLO, ein synthetischer Monitor, ein kontrolliertes Canary-Deployment. Bauen Sie schrittweise über 6 Monate auf.
- Synthetisches Monitoring validiert, dass reale Nutzerreisen aus Sicht des Nutzers funktionieren. Canary-Deployments erkennen Probleme, bevor sie 100 % des Datenverkehrs erreichen. Chaos-Tests decken verborgene Annahmen auf.
- SLOs verwandeln „die Anwendung fühlt sich langsam an“ in messbare Qualitätsanforderungen, die Release-Entscheidungen steuern.
- Blast Radius, Auto-Rollback und Not-Aus-Schalter machen Produktionsexperimente sicher und nicht riskant.
- QE, SRE und Entwicklung, die zusammen auf Shift-Right ausgerichtet sind, schaffen bessere Erkenntnisse darüber, wie das System tatsächlich funktioniert; keine zusätzlichen Konflikte.
- KI-gestützte Testautomatisierung beschleunigt den Feedback-Zyklus und wandelt Vorfallanalysen in Regressionstests in Minuten statt Stunden um.
Einführung
Seit Jahren lautet der Rat im Qualitätsengineering in eine Richtung: Shift Left. Früher testen. QE in Design-Reviews einbinden. Den Fehler abfangen, solange es noch günstig ist. Das ist ein guter Rat und hat funktioniert – die Teams, in denen ich war, haben tatsächlich mehr Probleme früher gefunden, sobald wir es ernst genommen haben.
Aber es gibt eine Lücke, die Shift Left nie schließt, und so zu tun, als ob, hat uns schon einige unangenehme Samstage gekostet. Keine Menge an Tests vor der Produktion sagt vollständig voraus, wie echte Nutzer, reale Datenmengen und echte Infrastruktur um 2 Uhr morgens unter einer Belastung zusammenwirken, die Sie nicht simuliert haben. Staging ist ein Modell der Produktion, und Modelle lassen Dinge weg.
Folgendes ist mir aufgefallen: Die Teams, die es mit beobachtbarkeitsgesteuertem Testen ernst meinen, finden nicht nur schneller Probleme. Sie verstehen warum sie passieren. Sie verbringen weniger Zeit damit, die Ursache zu erraten, und mehr Zeit damit, auf echte Signale zu reagieren. Wenn sie einen Vorfall erfassen, priorisieren sie ihn binnen Minuten statt Stunden. Und der größte Unterschied? Sie schließen den Kreis – Vorfälle werden zu Regressionstests, Tests werden zu Leitplanken, und dieselbe Fehlerklasse entkommt nie zweimal. KI-gesteuerte Testautomatisierung beschleunigt diesen Zyklus, indem sie Vorfallanalysen in automatisierte Regressionstests in Minuten statt Stunden verwandelt.
Die meisten Teams reden über Shift-Right-Testing. Weniger setzen es tatsächlich um. Das heißt, wenn Sie jetzt starten, sind Sie der Kurve voraus.
Beobachtbarkeitsgesteuertes Testen – die Praxis, die Produktion als Ihre reichhaltigste Quelle für Qualitätsinformationen zu behandeln – zielt nicht darauf ab, QE und SRE nervös zu machen. Es geht darum, beiden Teams bessere Beweise darüber zu liefern, wie sich das System gerade dann verhält, wenn es am wichtigsten ist. Dieser Artikel zeigt, wie das in der Praxis aussieht und wie man es einführt, ohne Ängste zu erzeugen.
Kontext & Auswirkung
Monitoring sagt Ihnen, dass es ausgefallen ist. Observability sagt Ihnen, warum.
Traditionelles Monitoring beantwortet eine Ja/Nein-Frage: Ist das System online? Observability stellt die schwierigere Frage: Warum verhält sich das System so?
Logs, Metriken und Traces bieten der QE eine weitere Beweisquelle, ohne dass ein neuer Build erforderlich ist. Observability-getriebenes Testen nutzt diese Telemetriedaten, um zu verstehen, was echte Nutzer tun und wo das System von den Erwartungen abweicht.
Die praktische Verbindung sieht folgendermaßen aus:
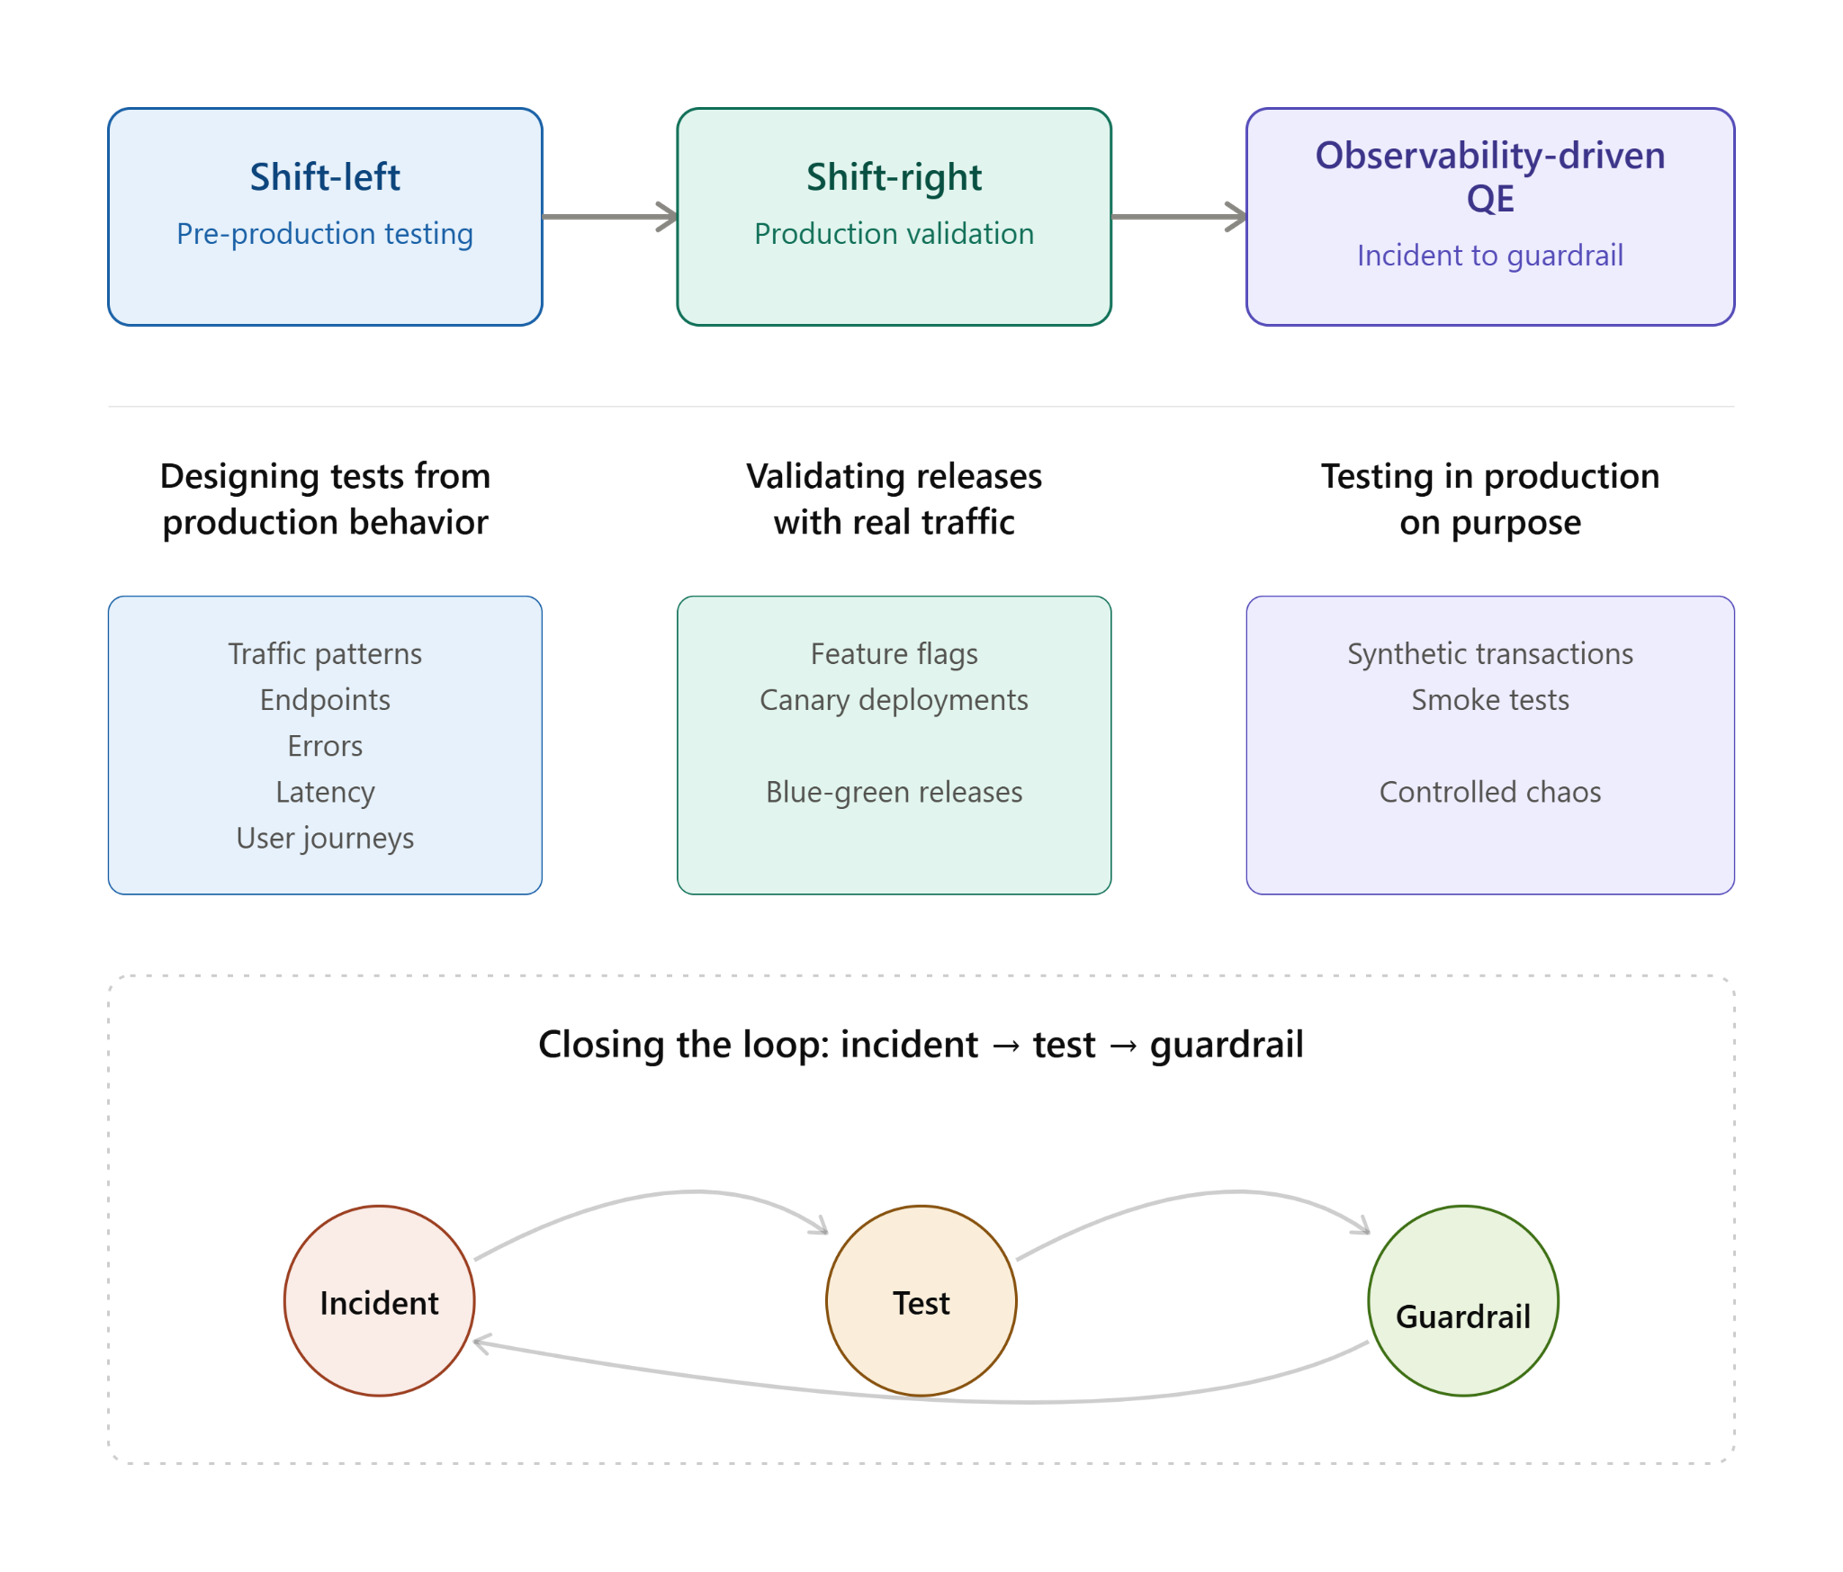
Wo es funktioniert
Die Praktiken, die sich lohnen
Synthetisches Monitoring
Skriptgesteuerte Abläufe werden in der Produktion aus mehreren Regionen ausgeführt. Das Ziel ist nicht, jede Funktion kontinuierlich zu testen, sondern sicherzustellen, dass die wichtigsten Nutzerabläufe aus Anwendersicht funktionieren.
Beispiel – Synthetische Playwright Checkout-Reise
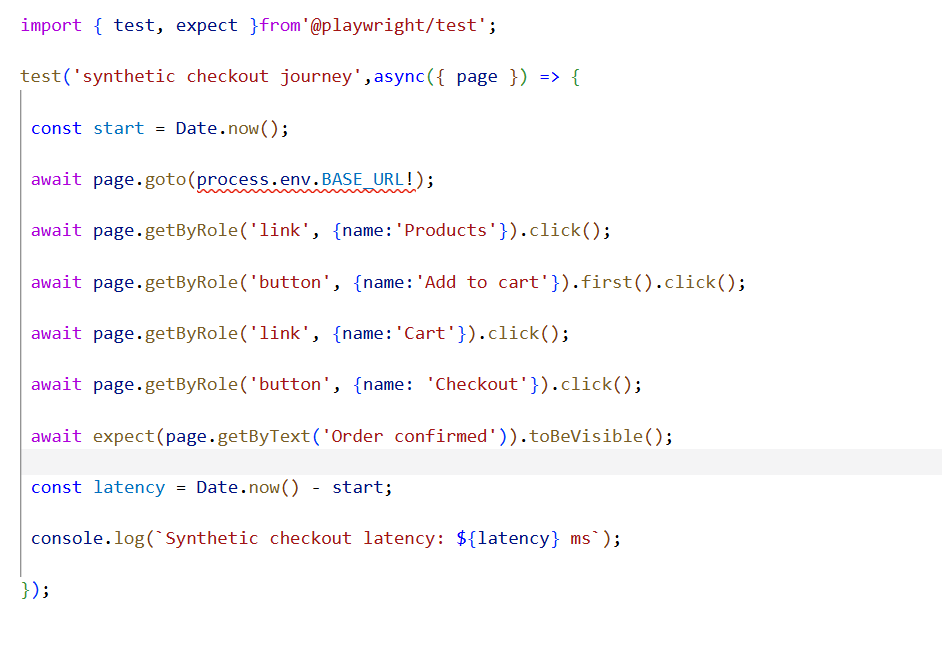
Der wesentliche Unterschied besteht darin, dass hier sichere synthetische Daten und Transaktionen verwendet werden sollten, damit die Überwachung nicht versehentlich echte Bestellungen, Zahlungen oder Kundendaten erzeugt.
Canary-Analyse
Ein kleiner Prozentsatz an realen Nutzern erhält die neue Version, während das System den Canary mit der stabilen Version vergleicht.
Ein einfacher Rollout könnte folgendermaßen aussehen: 5 % → 25 % → 50 % → 100 %
In jeder Phase vergleichen Sie:
- Fehlerrate
- Latenz
- Geschäftsmetriken
- Konversions- oder Abschlussrate
- Infrastrukturzustand
Wenn der Canary den vereinbarten Schwellenwert überschreitet, sollte automatisch ein Rollback erfolgen, ohne auf eine Dashboard-Benachrichtigung zu warten.
Beispiel – Canary-Promotion-Logik
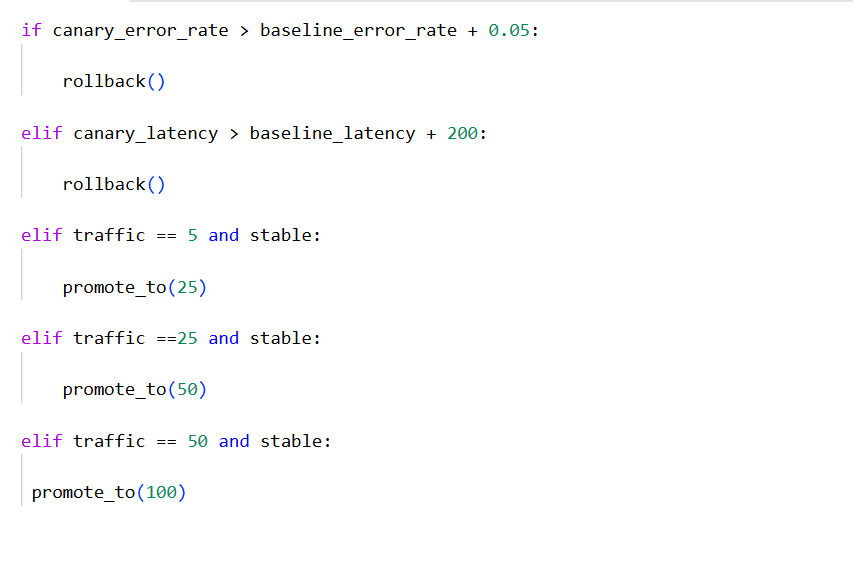
Die genauen Schwellenwerte sollten für die jeweilige Anwendung definiert werden, nicht blind von einem anderen Team übernommen.
Service Level Objectives als Qualitätsgrenzen
Ein SLO verwandelt „die Anwendung fühlt sich langsam an“ in eine messbare Qualitätsanforderung.
Beispiel:
Checkout-SLO
- Erfolg: 99,5 % der Checkout-Anfragen sind im monatlichen Messzeitraum erfolgreich.
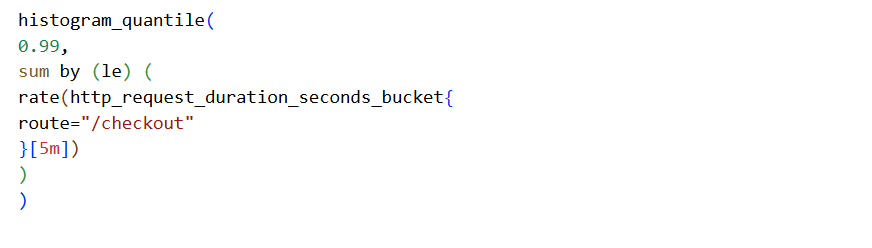
- Latenz: Die Latenz beim Checkout im 99. Perzentil bleibt unter 2 Sekunden. Erfahren Sie, wie Sie die Einhaltung des SLO unter Produktionslast validieren.
Das gibt dem Team ein Fehlerbudget von 0,5 % für fehlgeschlagene Checkout-Anfragen. Solange das Fehlerbudget in Ordnung ist, kann das Team die normale Auslieferung fortsetzen.
Wenn das Fehlerbudget schnell aufgebraucht wird, wird das Qualitätsrisiko zu einer Veröffentlichungsentscheidung und nicht nur zu einer weiteren Dashboard-Benachrichtigung.
Beispiel – Prometheus p99 Latenz-Abfrage
Beispiel – Checkout-Fehlerrate
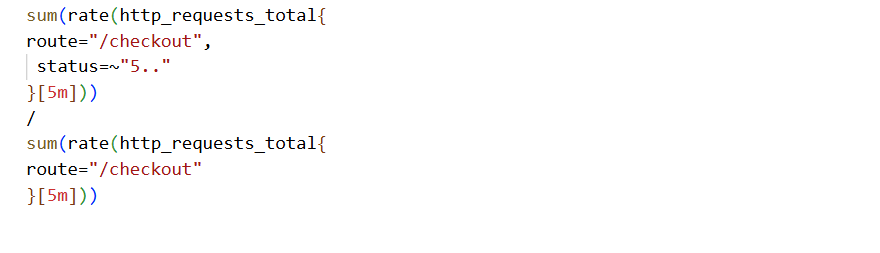
QE sollte diese Zahlen nicht nur konsumieren. QE sollte dabei helfen zu definieren, welche Kundenreisen wichtig sind, wie „gut“ aussieht und welche Schwellenwerte die Veröffentlichungsentscheidungen beeinflussen sollten.
Chaos- und Resilienztests
Kontrollierte Fehler decken Annahmen auf, die bei normalen Funktionstests selten berührt werden.
Der Rollout sollte wohlüberlegt sein:
Phase 1 – Staging
Fehlerszenarien in einer kontrollierten Umgebung testen.
Phase 2 – Produktions-Canary
Fehler in einem begrenzten Produktionsumfang, z. B. 5 %, einführen.
Phase 3 – Geplante Produktionsexperimente
Genehmigte Experimente in einem definierten Zeitfenster mit den richtigen Teams durchführen.
Mögliche Szenarien sind:
- Nicht verfügbare Datenbank-Replik
- Verlangsamte API-Antwort
- Timeout bei Abhängigkeit
- Speicherdruck
- Netzwerkverschlechterung
Beispiel – Datenbank-Replik-Ausfall-Experiment
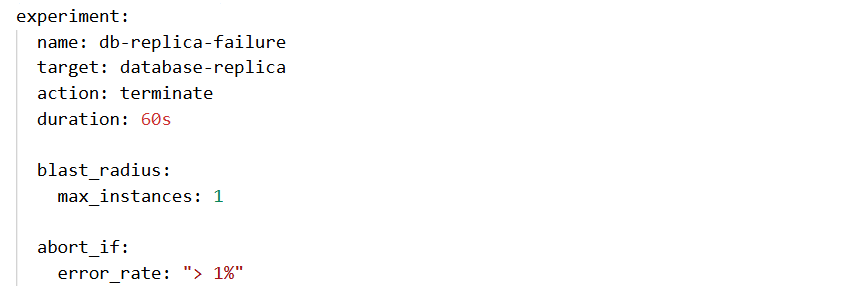
Das YAML ist eine illustrative Experiment-Definition; die tatsächliche Implementierung hängt von der verwendeten Chaos-Plattform ab.
Jedes Experiment braucht Schutzmechanismen: automatisches Rollback, einen Kill-Switch, einen definierten Blast-Radius und klare Abbruchbedingungen.
Vorfallrückführung in die Testsuite
Jeder signifikante Vorfall sollte eine Frage beantworten:
Welcher Test oder welche Schutzvorrichtung hätte diesen früher erkannt?
Stellen Sie sich beispielsweise einen Vorfall bei der Zahlungsabwicklung vor, bei dem ein vorübergehender Ausfall des Zahlungsanbieters ein fehlerhaftes Wiederholungsverhalten verursachte. Der Vorfall ist gelöst, aber die Arbeit sollte hier nicht enden.
Der Regressionstest sollte reproduzieren:
- Der erste Zahlungsversuch schlägt vorübergehend fehl.
- Es erfolgt ein Wiederholungsversuch.
- Der zweite Versuch gelingt.
- Der Kunde sieht eine erfolgreiche Zahlung.
- Es wird keine doppelte Zahlung erstellt.
- Das Monitoring bestätigt das erwartete Verhalten.
Beispiel – Vorfall-zu-Test
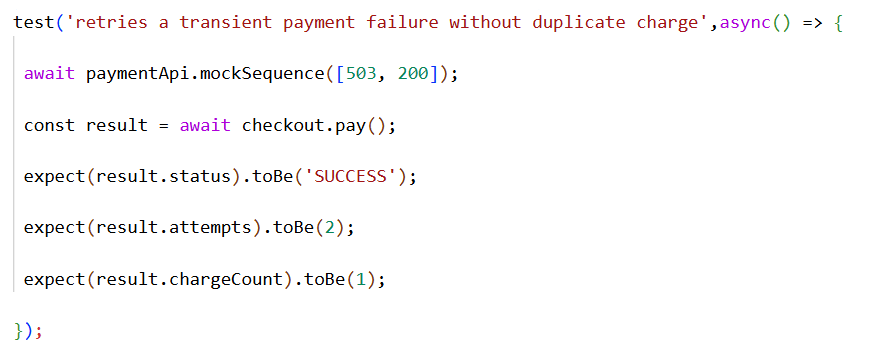
Der entscheidende Teil ist nicht die exakte Testsprache, sondern der Feedback-Zyklus:
Vorfall → Ursache → Regressionstest → Monitoring-Regel → künftige Schutzvorrichtung
Tools & Umsetzung
Tool-Ökosystem
Es gibt keinen einzigen richtigen Observability-Stack. Die richtige Wahl hängt von Umfang, bestehender Infrastruktur, technischer Reife und Budget ab.
Monitoring
Datadog
Gut geeignet, wenn ein Team eine verwaltete Observability-Plattform mit breiten Integrationen und weniger zu wartender Infrastruktur wünscht.
Prometheus + Grafana
Eine starke Option für Teams, die Flexibilität und eine Open-Source-Basis wollen und sich mit dem Betrieb des Stacks wohlfühlen.
New Relic
Nützlich für Teams, die eine integrierte Plattform für Anwendungs-Performance und Observability suchen.
Synthetisches Testing
Playwright DIY
Gut, wenn QE maximale Kontrolle über Abläufe, Prüfungen, Testdaten und CI/CD-Integration möchte.
Verwaltetes synthetisches Monitoring
Nützlich, wenn die Organisation weniger operativen Pflegeaufwand, verteilte Ausführung und integrierte Monitoring-Fähigkeiten wünscht.
Canary Deployment
Flagger
Nützlich für Kubernetes-orientierte progressive Auslieferung.
Spinnaker
Eine umfangreichere Continuous-Delivery-Plattform für Organisationen mit komplexeren Deployment-Anforderungen.
Cloud-native Deployment-Steuerungen
Oft die einfachste Wahl, wenn die Cloud-Plattform bereits die erforderlichen Traffic-Shifting- und Rollback-Funktionen bietet.
Die Entscheidung sollte mit dem zu lösenden Problem beginnen, nicht mit dem Namen des Tools.
Möchten Sie verstehen, wie KI diese Entscheidungen beschleunigt? Hören Sie unseren Podcast zu Wie KI modernes Quality Engineering neu gestaltet
Risiken & Governance
Blast-Radius
Beginnen Sie mit kleinen Verkehrsanteilen, automatischem Rollback und einem Not-Aus-Schalter.
Datenintegrität
Synthetische Transaktionen dürfen niemals Analysen, Fulfillment, Finanzberichte oder Kundendaten verfälschen. Testdatenverkehr sollte klar gekennzeichnet und isoliert sein.
Alarmmüdigkeit
Verknüpfen Sie Alarme mit SLOs und tatsächlichen Nutzerbeeinträchtigungen, statt für jede Metrikschwankung Alarme zu erzeugen.
Datenschutz
Sensibles Telemetrie-Material sollte bereinigt, tokenisiert oder ausgeschlossen werden, bevor es Analysesysteme erreicht.
Organisationale Bereitschaft
QE, Entwicklung und SRE müssen sich über den Zweck von Produktionstests einigen. Das Ziel ist Lernen und Resilienz, nicht Schuldzuweisung.
Voraussetzungen
Bevor Sie umfassendes Shift-Right-Testing einführen, sollten drei Dinge bestehen:
- Instrumentierung — Logs, Metriken, Traces und nützliche Geschäftstelemetrie.
- Schuldfreie Kultur — Vorfälle werden als Lernmöglichkeiten betrachtet.
- Runbooks — Teams wissen, was zu tun ist, wenn ein Experiment oder Release einen Schwellenwert überschreitet.
Ohne diese Grundlagen kann Produktionstesting mehr Lärm als Nutzen erzeugen.
Implementierungsfahrplan
Wie ich anfangen würde
Statt zu versuchen, alles auf einmal umzusetzen, würde ich die Fähigkeit Monat für Monat aufbauen.
Monat 1 — Sichtbarkeit
Die wichtigsten Nutzerreisen instrumentieren und Basiskennzahlen festlegen.
Monat 2 — Synthetisches Monitoring
Die drei wichtigsten kritischen Produktionswege automatisieren.
Monat 3 — SLO
Mindestens ein sinnvolles SLO definieren und mit dem Tracking des Fehlerbudgetverbrauchs beginnen.
Monat 4 — Canary
Einen einzelnen Service per Canary testen und den Vergleich zwischen stabiler und Canary-Version automatisieren.
Monat 5 — Chaos im Staging
Kontrollierte Fehlerszenarien im Staging einführen und den Rollback-Prozess validieren.
Monat 6 — Chaos in der Produktion
Ein sorgfältig kontrolliertes 5%-Produktionsexperiment durchführen.
Monat 7+
Den Feedback-Loop normalisieren:
Incident → Test → Alert → Guardrail → Besseres Release
Erfolg messen
Zielmetriken für sechs Monate
Die genaue Ausgangslage variiert je nach Organisation, aber ein nützliches Zielrahmenwerk könnte folgendermaßen aussehen:
Metrik | Ausgangspunkt | Ziel nach sechs Monaten |
MTTD | 15 Min. | 2 Min. |
MTTR | 45 Min. | 12 Min. |
Produktionsvorfälle | 8–12/Monat | 3–4/Monat |
Entwichene Fehler | 5–8/Monat | 1–2/Monat |
Alarmierungen im Bereitschaftsdienst | 12–15 | 3–5/Woche |
Die Zahlen sind weniger wichtig als die Etablierung eines Ausgangswerts und der Beleg, dass die Praktiken diesen in die richtige Richtung bewegen.
Fazit & nächste Schritte
Shift-left ist notwendig. Aber moderne Systeme sind verteilt, datenhungrig und werden auf eine Weise genutzt, die kein Testplan vollständig voraussehen kann.
Observability-getriebenes Testen erstreckt die Qualitätssicherung über den gesamten Lebenszyklus. Produktions-Telemetrie hilft bei der Entscheidung, was getestet werden soll. Echter Datenverkehr validiert, was Vorproduktionsumgebungen nicht vollständig reproduzieren können. Zwischenfälle werden zu Regressionstests, und diese Tests werden zu Leitplanken für zukünftige Releases.
Das Ziel ist nicht, vor der Freigabe weniger zu testen.
Es ist, aufzuhören, die Freigabe als Ende des Testens zu behandeln.
Für eine ausgereifte Qualitätssicherungsorganisation bedeutet Shift-right nicht, QE in Konflikt mit SRE oder Entwicklung zu bringen. Es geht darum, allen drei Teams bessere Nachweise darüber zu liefern, wie das System im entscheidenden Moment funktioniert.
Der nächste Schritt ist, klein anzufangen: eine kritische Nutzerreise, ein SLO, eine synthetische Überwachung und ein kontrolliertes Canary-Deployment.
Dann messen Sie das Ergebnis.
Die Produktion sollte nicht als Ort betrachtet werden, an dem das Testen endet. Mit der richtigen Observability, Leitplanken und Kultur kann sie eine der reichhaltigsten Quellen für Qualitätsinformationen werden, die das Team hat.
Bereit, Shift-right-Praktiken im großen Maßstab umzusetzen?
Entdecken Sie TO THE NEWs Quality Engineering Services für umfassende Unterstützung: Observability-Strategie, Einrichtung synthetischer Überwachung, Definition von SLOs, Automatisierung von Canary-Deployments und laufende Governance.