Puntos clave: pruebas shift-right
- El shift-left es necesario, pero no lo captura todo. Los usuarios reales, volúmenes reales de datos e infraestructura real a las 2 a.m. se comportan de manera diferente que en tu entorno de staging.
- Producción es tu fuente más rica de señales de calidad. Deja de tratarla como el lugar donde termina la prueba.
- Los incidentes se convierten en pruebas de regresión. Las pruebas de regresión se convierten en barandillas de protección. Cierra el ciclo y la misma falla nunca volverá a pasar dos veces.
- Las pruebas impulsadas por la observabilidad requieren tres fundamentos: instrumentación, cultura sin culpas y runbooks. Sin ellos, solo creas ruido.
- Comienza pequeño: un recorrido crítico, un SLO, un monitor sintético, un canario controlado. Construye de forma incremental durante 6 meses.
- El monitoreo sintético valida que los recorridos reales de usuarios funcionen desde la perspectiva del usuario. Los despliegues canario detectan problemas antes de que afecten al 100% del tráfico. Las pruebas de caos exponen suposiciones ocultas.
- Los SLO convierten "la aplicación se siente lenta" en expectativas de calidad medibles que guían las decisiones de lanzamiento.
- El radio de explosión, la reversión automática y los interruptores de apagado hacen que los experimentos en producción sean seguros, no imprudentes.
- QE, SRE y desarrollo alineados en shift-right significa mejor evidencia sobre cómo se comporta realmente el sistema; no más conflictos.
- La Automatización de Pruebas liderada por IA acelera el ciclo de retroalimentación, convirtiendo el análisis de incidentes en pruebas de regresión en minutos en lugar de horas.
Introducción
Durante años, el consejo en ingeniería de calidad ha señalado en una dirección: desplazar a la izquierda. Probar antes. Involucrar a QE en las revisiones de diseño. Detectar el defecto cuando aún es barato. Es un buen consejo y funcionó: los equipos en los que he estado realmente encontraron más problemas antes una vez que lo tomamos en serio.
Pero hay una brecha que el desplazamiento a la izquierda nunca cierra, y fingir que sí nos ha costado algunos sábados incómodos. Ninguna cantidad de pruebas previas a producción predice completamente cómo se comportan juntos los usuarios reales, los volúmenes reales de datos y la infraestructura real a las 2 a. m. bajo una carga que no simulaste. El entorno de staging es un modelo de producción, y los modelos dejan cosas fuera.
Esto es lo que he notado: los equipos que se ponen serios con las pruebas impulsadas por la observabilidad no solo encuentran problemas más rápido. También entienden por qué están sucediendo. Dedican menos tiempo a adivinar la causa raíz y más tiempo a actuar basándose en señales reales. Cuando detectan un incidente, lo priorizan en minutos en lugar de horas. ¿Y la mayor diferencia? Cierran el ciclo: los incidentes se convierten en pruebas de regresión, las pruebas en líneas de defensa, y la misma clase de fallo nunca se repite dos veces. La automatización de pruebas dirigida por IA acelera este ciclo, convirtiendo el análisis de incidentes en pruebas de regresión automatizadas en minutos en vez de horas.
La mayoría de los equipos habla de pruebas desplazadas a la derecha. Menos las implementan realmente. Lo que significa que si comienzas ahora, estás adelantado a la curva.
Las pruebas impulsadas por la observabilidad, la práctica de tratar la producción como tu fuente más valiosa de señales de calidad, no buscan poner nerviosos a QE y SRE. Buscan proporcionar a ambos equipos mejor evidencia sobre cómo se comporta el sistema cuando más importa. Este artículo cubre cómo se ve eso en términos prácticos y cómo implementarlo sin generar ansiedad.
Contexto e impacto
La monitorización te indica que está caído. La observabilidad te dice por qué.
La monitorización tradicional responde a una pregunta de sí/no: ¿el sistema está operativo? La observabilidad plantea una pregunta más difícil: ¿por qué el sistema se está comportando así?
Los registros, métricas y trazas ofrecen a QE otra fuente de evidencia sin requerir una nueva compilación. Las pruebas basadas en observabilidad usan esa telemetría para entender qué hacen los usuarios reales y dónde el sistema se comporta de manera diferente a lo esperado.
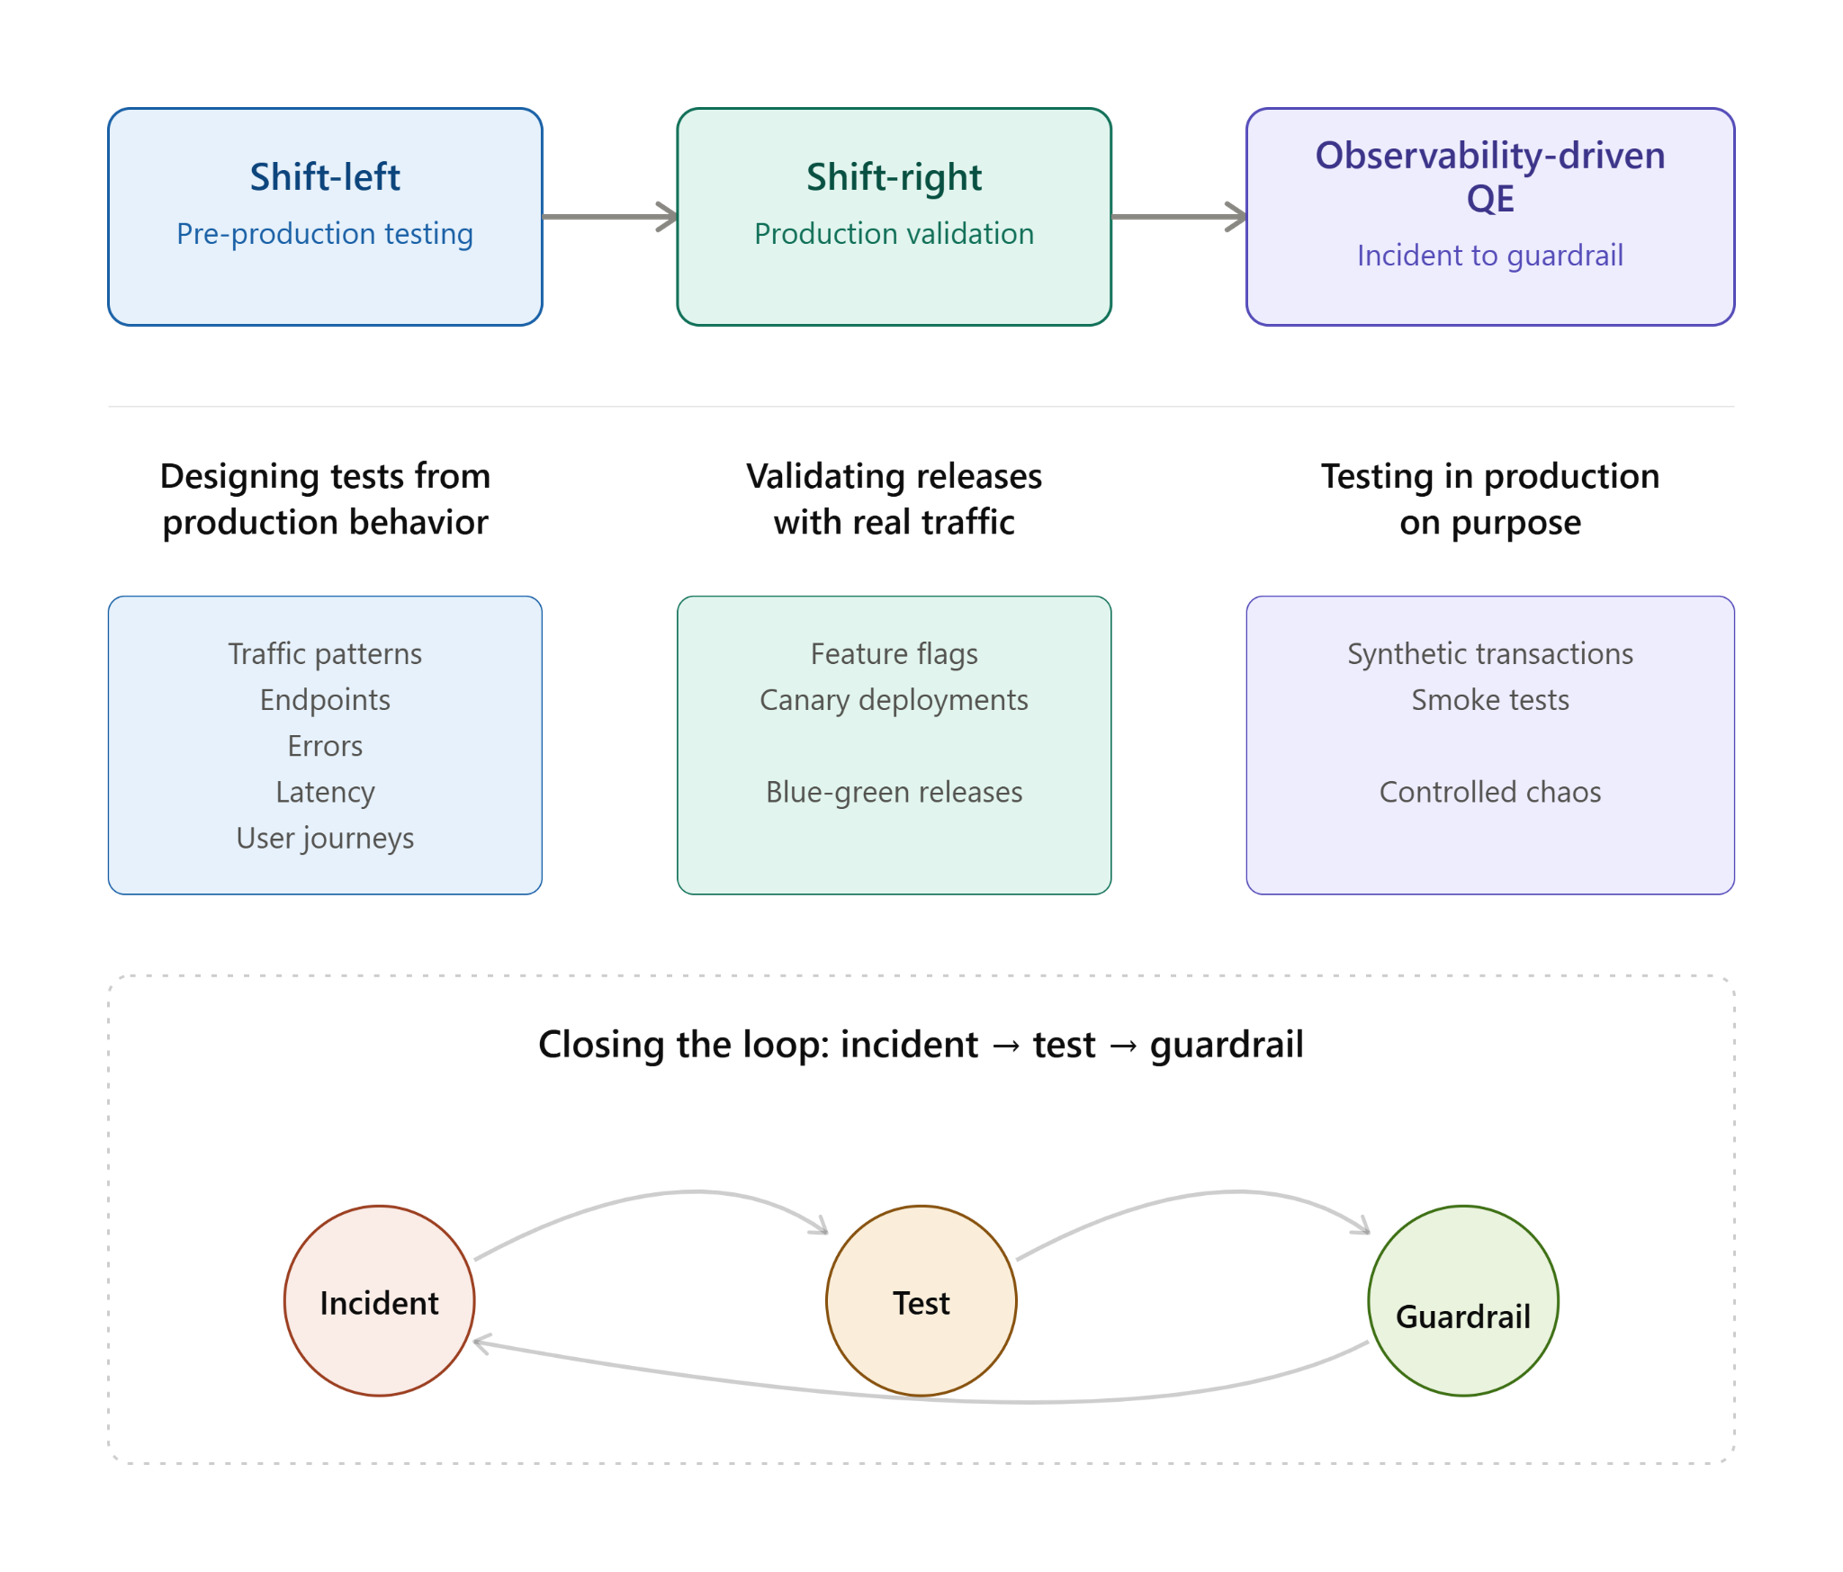
La conexión práctica se ve así:
Dónde funciona
Las prácticas que vale la pena adoptar
Monitoreo sintético
Recorridos con guiones ejecutados en producción desde múltiples regiones. El objetivo no es probar cada función continuamente. Es asegurarse de que los recorridos de usuario más importantes funcionen desde la perspectiva del usuario.
Ejemplo — Recorrido de pago sintético con Playwright
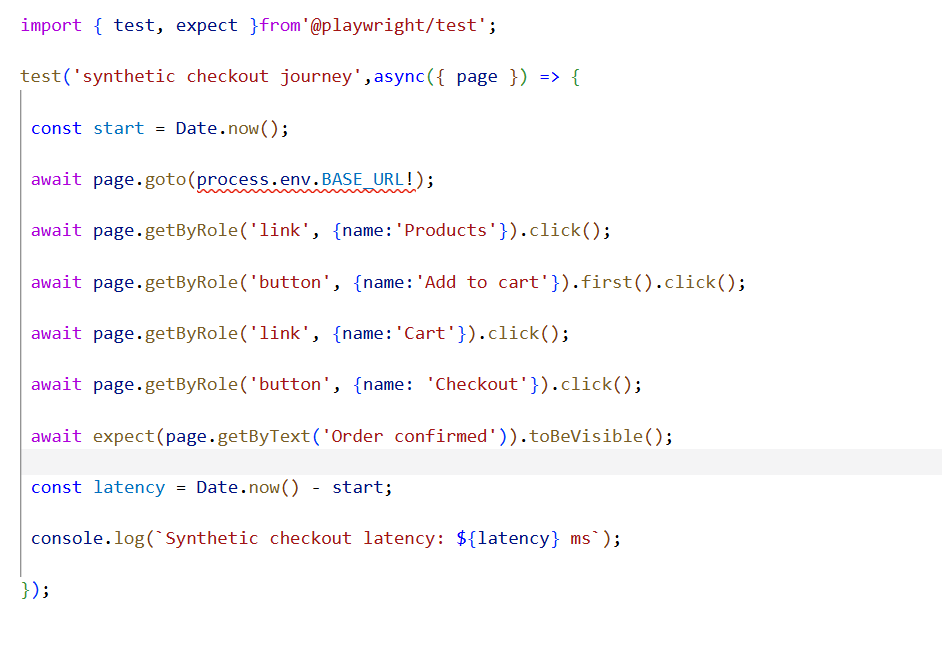
La distinción importante es que esto debe usar datos sintéticos y transacciones seguras, para que el monitor no cree accidentalmente pedidos reales, pagos o registros de clientes.
Análisis canario
Un pequeño porcentaje de usuarios reales recibe la nueva versión mientras el sistema compara el canario con la versión estable.
Un despliegue sencillo podría ser: 5% → 25% → 50% → 100%
En cada etapa, comparar:
- Tasa de errores
- Latencia
- Métricas de negocio
- Tasa de conversión o finalización
- Estado de la infraestructura
Si el canario supera el umbral acordado, la reversión debe ocurrir automáticamente en lugar de esperar a que alguien note en un panel.
Ejemplo — Lógica de promoción canario
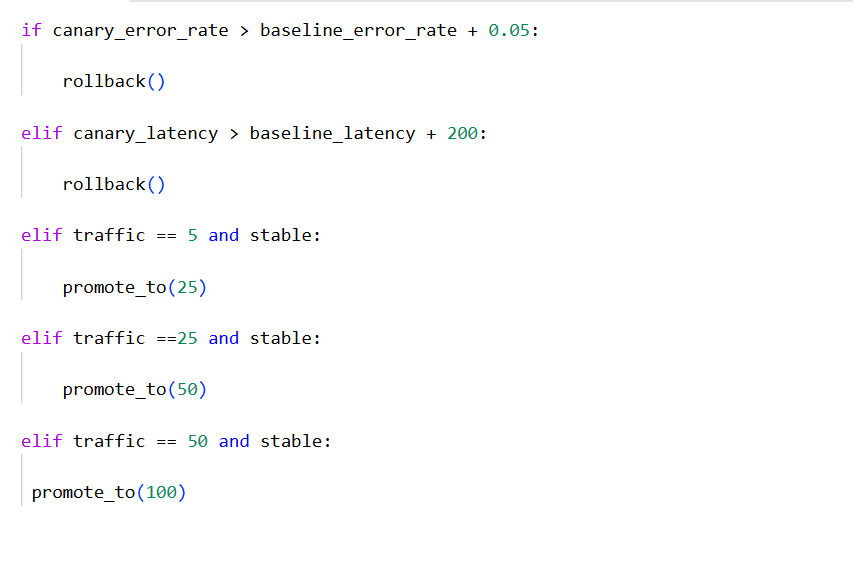
Los umbrales exactos deben definirse para la aplicación, no copiarse ciegamente de otro equipo.
Objetivos de nivel de servicio como puertas de calidad
Un SLO convierte “la aplicación se siente lenta” en una expectativa de calidad medible.
Por ejemplo:
SLO de pago
- Éxito: El 99.5% de las solicitudes de pago tienen éxito durante la ventana mensual de medición.
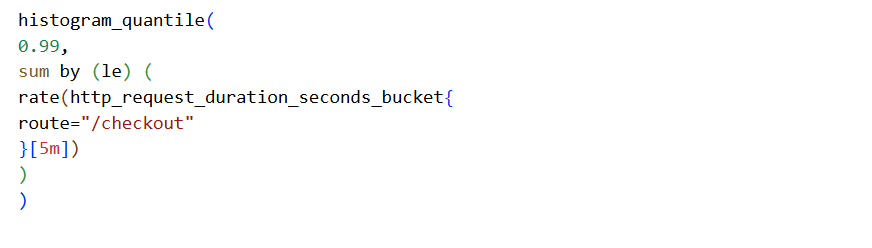
- Latencia: La latencia en el percentil 99 del pago se mantiene por debajo de 2 segundos. Aprende cómo validar el cumplimiento del SLO bajo carga de producción.
Eso da al equipo un presupuesto de error del 0.5% para solicitudes de pago fallidas. Cuando el presupuesto de error está sano, el equipo puede continuar con la entrega normal.
Cuando el presupuesto se consume rápidamente, el riesgo de calidad se convierte en una decisión de lanzamiento, no solo en otra notificación en el panel.
Ejemplo — Consulta de latencia p99 en Prometheus
Ejemplo — Tasa de errores en pago
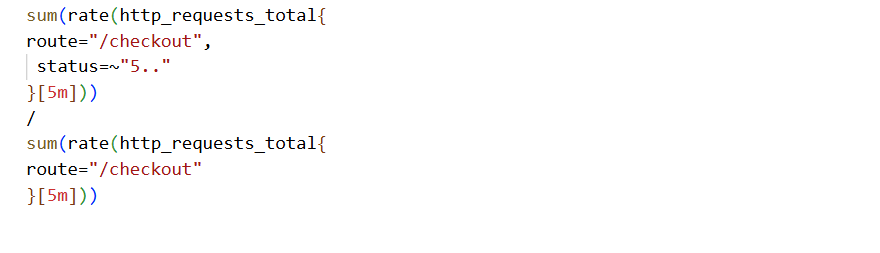
QE no debería solo consumir estos números. QE debe ayudar a definir qué recorridos de clientes importan, cómo se ve lo “bueno” y qué umbrales deberían influir en las decisiones de lanzamiento.
Pruebas de caos y resiliencia
Las fallas controladas revelan suposiciones que las pruebas funcionales normales rara vez tocan.
El despliegue debe ser deliberado:
Etapa 1 — Preproducción
Probar escenarios de fallos en un entorno controlado.
Etapa 2 — Canario en producción
Introducir la falla en un ámbito limitado de producción, como el 5%.
Etapa 3 — Experimentos programados en producción
Ejecutar experimentos aprobados durante una ventana definida con los equipos adecuados disponibles.
Los escenarios posibles incluyen:
- Réplicas de base de datos no disponibles
- Ralentización de respuestas de API
- Tiempo de espera en dependencias
- Presión en la memoria
- Degradación de red
Ejemplo — Experimento de fallo en réplica de base de datos
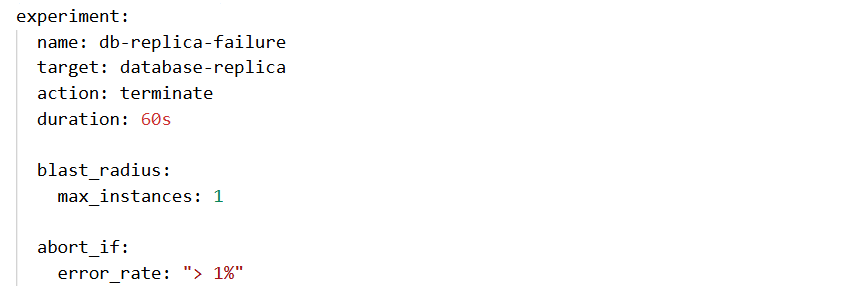
El YAML es una definición ilustrativa del experimento; la implementación real depende de la plataforma de caos utilizada.
Cada experimento necesita límites claros: reversión automática, interruptor de emergencia, radio de impacto definido y condiciones claras de abortar.
Incorporar incidentes al conjunto de pruebas
Cada incidente significativo debe responder a una pregunta:
¿Qué prueba o límite hubiera detectado esto antes?
Por ejemplo, imagina un incidente en el procesamiento de pagos donde una falla transitoria del proveedor causó un comportamiento incorrecto en el reintento. El incidente se resuelve, pero el trabajo no debe terminar ahí.
La prueba de regresión debería reproducir:
- El primer intento de pago falla temporalmente.
- Se realiza el reintento.
- El segundo intento tiene éxito.
- El cliente ve un pago exitoso.
- No se crea un pago duplicado.
- El monitoreo confirma el comportamiento esperado.
Ejemplo — Incidente a prueba
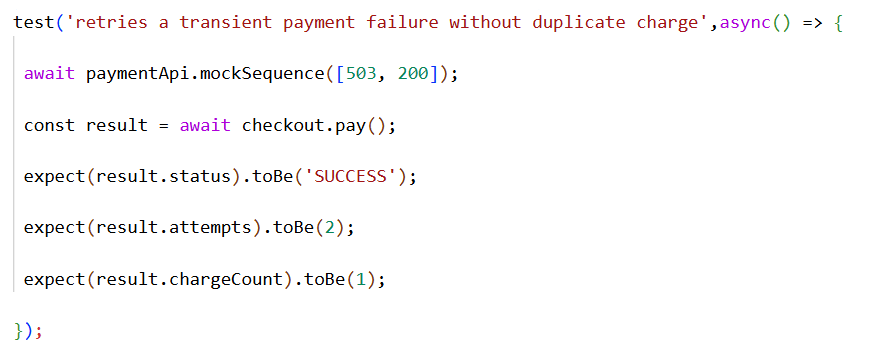
La parte importante no es la sintaxis exacta de la prueba. Es el ciclo de retroalimentación:
Incidente → Causa raíz → Prueba de regresión → Regla de monitoreo → Límite futuro
Herramientas y implementación
Ecosistema de herramientas
No existe una única pila de observabilidad correcta. La elección adecuada depende de la escala, la infraestructura existente, la madurez del equipo de ingeniería y el presupuesto.
Monitoreo
Datadog
Una buena opción cuando un equipo desea una plataforma de observabilidad gestionada con integraciones amplias y menos infraestructura que mantener.
Prometheus + Grafana
Una opción sólida para equipos que quieren flexibilidad, una base de código abierto y están cómodos operando la pila.
New Relic
Útil para equipos que buscan una plataforma integrada de rendimiento de aplicaciones y observabilidad.
Pruebas sintéticas
Playwright DIY
Adecuado cuando QE quiere el máximo control sobre los recorridos, afirmaciones, datos de prueba e integración CI/CD.
Monitoreo sintético gestionado
Útil cuando la organización quiere menos mantenimiento operativo, ejecución distribuida y capacidades de monitoreo integradas.
Despliegue canario
Flagger
Útil para entregas progresivas orientadas a Kubernetes.
Spinnaker
Una plataforma de entrega continua más amplia para organizaciones con requisitos de despliegue más complejos.
Controles de despliegue nativos en la nube
A menudo la opción más sencilla cuando la plataforma en la nube ya ofrece las capacidades necesarias para el cambio de tráfico y reversión.
La decisión debe comenzar con el problema a resolver, no con el nombre de la herramienta.
¿Quieres entender cómo la IA acelera estas decisiones? Escucha nuestro podcast sobre Cómo la IA está transformando la ingeniería de calidad moderna
Riesgos y gobernanza
Radio de impacto
Comienza con pequeños porcentajes de tráfico, reversión automática y un interruptor de emergencia.
Integridad de los datos
Las transacciones sintéticas nunca deben contaminar los análisis, el cumplimiento, los informes financieros ni los datos de clientes. El tráfico de prueba debe estar claramente etiquetado y aislado.
Fatiga por alertas
Vincula las alertas a los SLO y al impacto real en el usuario en lugar de crear alertas por cada fluctuación métrica.
Privacidad
La telemetría sensible debe ser depurada, tokenizada o excluida antes de llegar a los sistemas de análisis.
Preparación organizacional
QE, desarrollo y SRE deben acordar el propósito de las pruebas en producción. El objetivo es el aprendizaje y la resiliencia, no asignar culpas.
Prerrequisitos
Antes de introducir pruebas shift-right a gran escala, querría tener tres cosas en su lugar:
- Instrumentación — registros, métricas, trazas y telemetría empresarial útil.
- Cultura sin culpas — los incidentes se tratan como oportunidades de aprendizaje.
- Runbooks — los equipos saben qué hacer cuando un experimento o lanzamiento supera un umbral.
Sin estas bases, las pruebas en producción pueden generar más ruido que valor.
Hoja de ruta de implementación
Cómo comenzaría
En lugar de intentar implementar todo de una vez, construiría la capacidad mes a mes.
Mes 1 — Visibilidad
Instrumentar los recorridos de usuario más importantes y establecer métricas base.
Mes 2 — Monitoreo Sintético
Automatizar los tres recorridos críticos principales en producción.
Mes 3 — SLO
Definir al menos un SLO significativo y comenzar a rastrear el consumo del presupuesto de errores.
Mes 4 — Canary
Realizar una prueba canary con un solo servicio y automatizar la comparación entre las versiones estable y canary.
Mes 5 — Chaos en Staging
Introducir escenarios de fallos controlados en staging y validar el proceso de reversión.
Mes 6 — Chaos en Producción
Ejecutar un experimento de producción controlado cuidadosamente con un 5%.
Mes 7+
Normalizar el ciclo de retroalimentación:
Incidente → Prueba → Alerta → Barrera de protección → Mejor lanzamiento
Medir el éxito
Métricas objetivo a seis meses
La línea base exacta variará según la organización, pero un marco objetivo útil podría ser el siguiente:
Métrica | Punto de partida | Objetivo a seis meses |
MTTD | 15 min | 2 min |
MTTR | 45 min | 12 min |
Incidentes en producción | 8–12/mes | 3–4/mes |
Defectos escapados | 5–8/mes | 1–2/mes |
Páginas de guardia | 12–15 | 3–5/semana |
Los números importan menos que establecer una línea base y demostrar que las prácticas la están moviendo en la dirección correcta.
Conclusión y próximos pasos
El enfoque shift-left es necesario. Pero los sistemas modernos son distribuidos, requieren grandes volúmenes de datos y se usan de maneras que ningún plan de pruebas puede anticipar por completo.
Las pruebas impulsadas por la observabilidad extienden la ingeniería de calidad (QE) a lo largo de todo el ciclo de vida. La telemetría en producción ayuda a decidir qué probar. El tráfico real valida lo que los entornos de preproducción no pueden reproducir completamente. Los incidentes se convierten en pruebas de regresión, y esas pruebas se convierten en líneas de control para futuros lanzamientos.
El objetivo no es probar menos antes del lanzamiento.
Es dejar de tratar el lanzamiento como el fin de las pruebas.
Para una organización madura de ingeniería de calidad, shift-right no trata de poner a QE en conflicto con SRE o desarrollo. Se trata de brindar a los tres equipos mejor evidencia sobre cómo se comporta el sistema cuando más importa.
El siguiente paso es comenzar pequeño: un recorrido crítico, un SLO, un monitor sintético y un canario controlado.
Luego medir el resultado.
No se debe tratar la producción como un lugar donde las pruebas se detienen. Con la observabilidad correcta, líneas de control y cultura, puede convertirse en una de las fuentes más ricas de inteligencia de calidad que tiene el equipo.
¿Listo para implementar prácticas shift-right a escala?
Explora Los Servicios de Ingeniería de Calidad de TO THE NEW para apoyo integral: estrategia de observabilidad, configuración de monitoreo sintético, definición de SLO, automatización de despliegue canario y gobernanza continua.