Poin-poin penting: ujian alih ke kanan
- Pendekatan shift-left diperlukan, tetapi ia tidak menangkap segala-galanya. Pengguna sebenar, volum data sebenar, dan infrastruktur sebenar pada pukul 2 pagi berkelakuan berbeza daripada persekitaran staging anda.
- Pengeluaran adalah sumber isyarat kualiti paling kaya anda. Berhenti menganggapnya sebagai tempat ujian berakhir.
- Insiden menjadi ujian regresi. Ujian regresi menjadi panduan keselamatan. Tutup gelung dan kegagalan yang sama tidak akan terlepas dua kali.
- Ujian berpandukan kebolehlihatan memerlukan tiga asas: instrumentasi, budaya tanpa menyalahkan, dan runbook. Tanpa mereka, anda hanya menghasilkan kebisingan.
- Mulakan kecil: satu perjalanan kritikal, satu SLO, satu pemantau sintetik, satu canary terkawal. Bina secara berperingkat selama 6 bulan.
- Pemantauan sintetik mengesahkan bahawa perjalanan pengguna sebenar berfungsi dari perspektif pengguna. Pelancaran canary menangkap masalah sebelum mencapai 100% trafik. Ujian chaos mendedahkan andaian tersembunyi.
- SLO menukar "aplikasi terasa perlahan" menjadi jangkaan kualiti yang boleh diukur yang mendorong keputusan pelancaran.
- Jejari letupan, auto-rollback, dan suis pembunuh membuatkan eksperimen pengeluaran selamat, bukan cuai.
- QE, SRE, dan pembangunan yang selari dalam shift-right bermakna bukti lebih baik mengenai bagaimana sistem sebenarnya berkelakuan; bukan lebih banyak konflik.
- Automasi Ujian Dipimpin AI mempercepatkan gelung maklum balas, menukar analisis insiden menjadi ujian regresi dalam beberapa minit dan bukan jam.
Pengenalan
Selama bertahun-tahun, nasihat dalam kejuruteraan kualiti telah menunjukkan satu arah: pindah ke kiri. Uji lebih awal. Libatkan QE dalam ulasan reka bentuk. Tangkap kecacatan semasa ia masih murah. Ini nasihat yang baik dan ia berkesan - pasukan yang saya sertai benar-benar menemui lebih banyak masalah lebih awal apabila kami mengambilnya dengan serius.
Tetapi ada jurang yang tidak dapat ditutup dengan hanya berpindah ke kiri, dan berpura-pura sebaliknya telah menyebabkan kami beberapa Sabtu yang tidak selesa. Tiada jumlah ujian pra-pengeluaran yang sepenuhnya meramalkan bagaimana pengguna sebenar, volum data sebenar, dan infrastruktur sebenar berfungsi bersama pada pukul 2 pagi di bawah beban yang anda tidak simulasi. Staging adalah model pengeluaran, dan model meninggalkan perkara-perkara tertentu.
Ini yang saya perhatikan: pasukan yang serius tentang ujian berasaskan pemerhatian bukan sahaja menemui masalah dengan lebih cepat. Mereka memahami mengapa ia berlaku. Mereka menghabiskan kurang masa meneka sebab utama dan lebih banyak masa bertindak berdasarkan isyarat sebenar. Apabila mereka menangkap insiden, mereka menguruskan dalam beberapa minit dan bukan jam. Dan perbezaan terbesar? Mereka menutup kitaran - insiden menjadi ujian regresi, ujian menjadi penghadang, dan kelas kegagalan yang sama tidak pernah terlepas dua kali. Automasi Ujian Dipimpin AI mempercepatkan kitaran ini, menukar analisis insiden menjadi ujian regresi automatik dalam beberapa minit dan bukannya jam.
Kebanyakan pasukan bercakap tentang ujian berpindah ke kanan. Lebih sedikit yang sebenarnya membinanya. Ini bermakna jika anda bermula sekarang, anda berada di hadapan.
Ujian berasaskan pemerhatian - amalan memperlakukan pengeluaran sebagai sumber isyarat kualiti paling kaya anda - bukan untuk membuat QE dan SRE rasa tidak senang. Ia adalah untuk memberikan kedua-dua pasukan bukti yang lebih baik tentang bagaimana sistem berfungsi apabila ia paling penting. Artikel ini membincangkan bagaimana ia kelihatan dalam istilah praktikal dan cara membawa masuk tanpa menimbulkan kegelisahan.
Konteks & impak
Pemantauan memberitahu anda sistem tidak berfungsi. Kebolehpengecaman memberitahu anda sebabnya.
Pemantauan tradisional menjawab soalan ya/tidak: adakah sistem berfungsi? Kebolehpengecaman bertanya soalan yang lebih sukar: mengapa sistem berkelakuan sedemikian?
Log, metrik, dan jejak memberikan QE sumber bukti lain tanpa memerlukan binaan baharu. Ujian berasaskan kebolehpengecaman menggunakan telemetri itu untuk memahami apa yang pengguna sebenar lakukan dan di mana sistem berkelakuan berbeza daripada jangkaan.
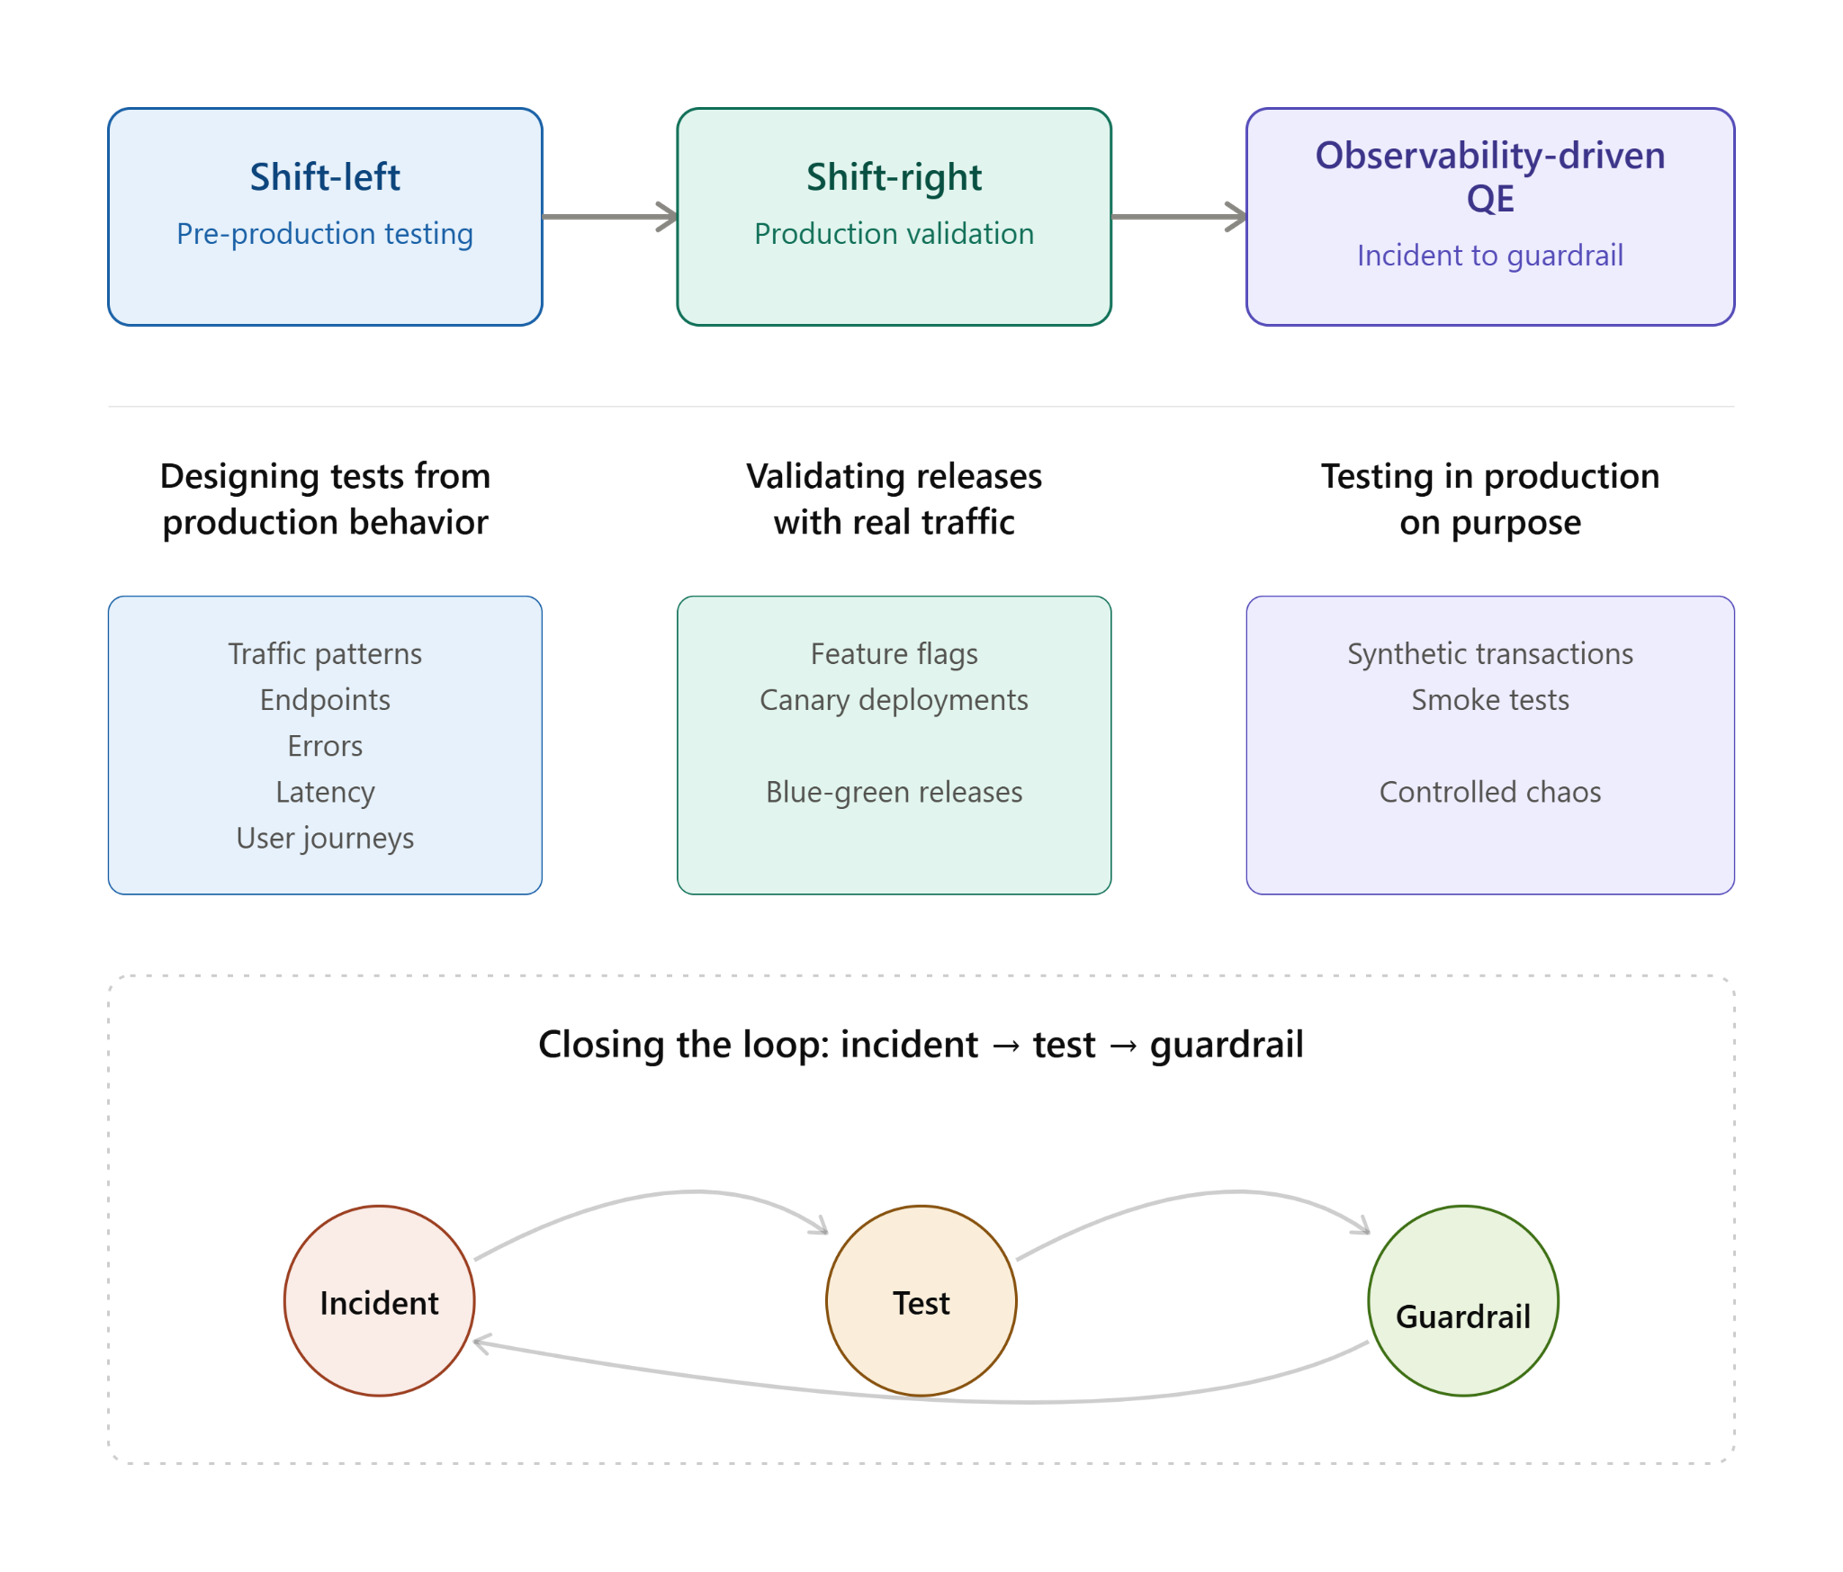
Sambungan praktikal kelihatan seperti ini:
Di mana ia berfungsi
Amalan yang berbaloi untuk diadopsi
Pemantauan sintetik
Perjalanan yang diskripkan dijalankan dalam produksi dari beberapa wilayah. Objektifnya bukan untuk menguji setiap ciri secara berterusan. Ia bertujuan untuk memastikan perjalanan pengguna yang paling penting berfungsi dari perspektif pengguna.
Contoh — Perjalanan Checkout Synthetic Playwright
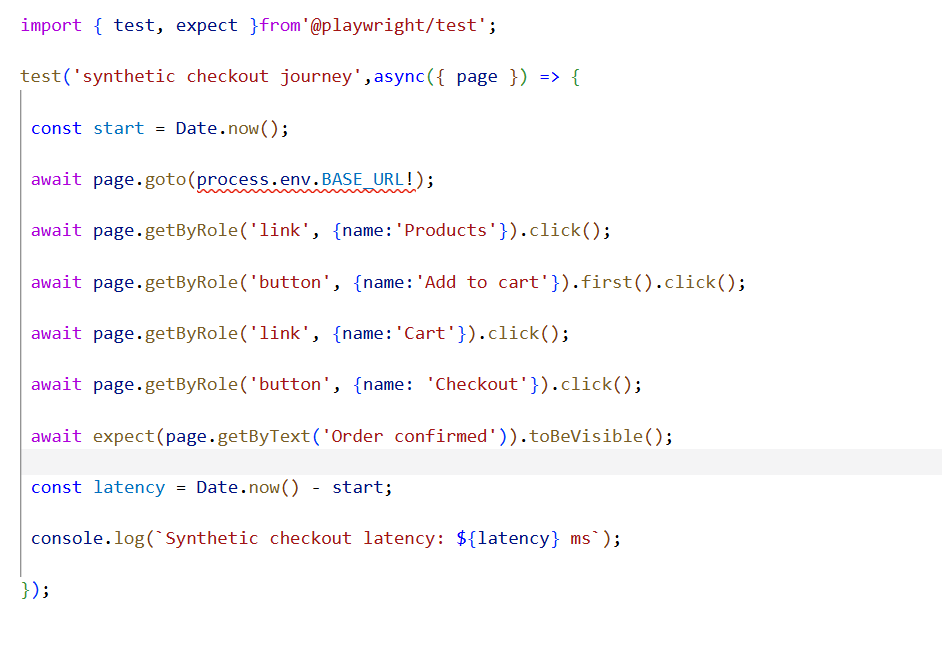
Perbezaan penting ialah ini harus menggunakan data sintetik dan transaksi yang selamat, supaya pemantau tidak secara tidak sengaja mencipta pesanan, pembayaran, atau rekod pelanggan sebenar.
Analisis Canary
Peratusan kecil pengguna sebenar menerima pelancaran baru sementara sistem membandingkan canary dengan versi stabil.
Pelancaran ringkas mungkin kelihatan seperti: 5% → 25% → 50% → 100%
Pada setiap peringkat, bandingkan:
- Kadar ralat
- Latensi
- Metrix perniagaan
- Kadar penukaran atau penyelesaian
- Kesihatan infrastruktur
Jika canary melepasi ambang yang dipersetujui, rollback harus dilakukan secara automatik dan bukan menunggu seseorang perasan pada papan pemuka.
Contoh — Logik Promosi Canary
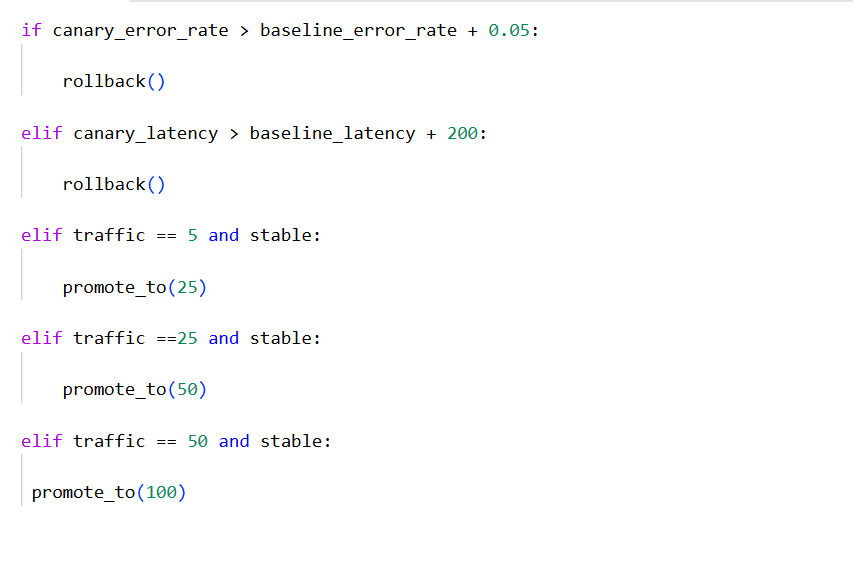
Ambang tepat harus ditetapkan untuk aplikasi dan bukannya disalin secara membuta dari pasukan lain.
Objektif tahap perkhidmatan sebagai pintu kualiti
SLO mengubah "aplikasi terasa perlahan" menjadi jangkaan kualiti yang boleh diukur.
Sebagai contoh:
SLO Checkout
- Kejayaan: 99.5% permintaan checkout berjaya dalam tempoh pengukuran bulanan.
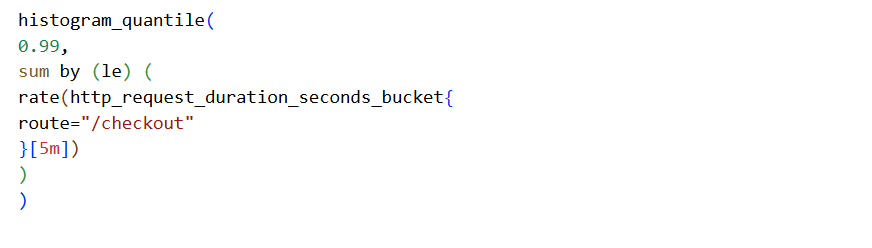
- Latensi: Latensi checkout persentil ke-99 kekal di bawah 2 saat. Ketahui cara mengesahkan pematuhan SLO di bawah beban produksi.
Ini memberi pasukan bajet ralat 0.5% untuk permintaan checkout yang gagal. Apabila bajet ralat berada dalam keadaan sihat, pasukan boleh meneruskan penghantaran biasa.
Apabila bajet digunakan dengan cepat, risiko kualiti menjadi keputusan pelancaran dan bukan sekadar notifikasi papan pemuka.
Contoh — Pertanyaan Latensi Prometheus p99
Contoh — Kadar Ralat Checkout
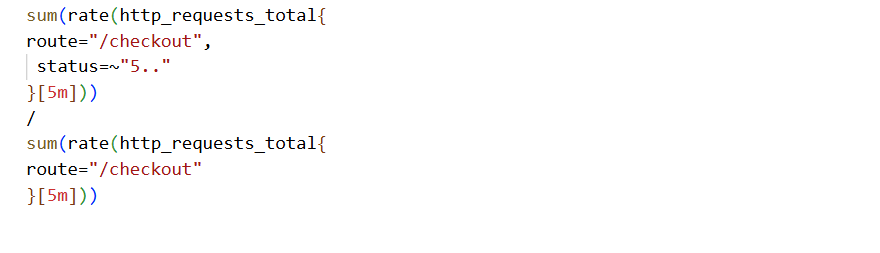
QE tidak seharusnya hanya menggunakan nombor ini. QE harus membantu menentukan perjalanan pelanggan mana yang penting, apakah rupa "baik", dan ambang mana yang harus mempengaruhi keputusan pelancaran.
Ujian kekacauan dan ketahanan
Kegagalan terkawal mendedahkan andaian yang jarang disentuh oleh ujian fungsi biasa.
Pelancaran harus dilakukan dengan sengaja:
Tahap 1 — Peringkat Staging
Uji senario kegagalan dalam persekitaran terkawal.
Tahap 2 — Canary produksi
Perkenalkan kegagalan kepada skop produksi yang terhad, seperti 5%.
Tahap 3 — Eksperimen produksi berjadual
Jalankan eksperimen yang diluluskan dalam tempoh yang ditetapkan dengan pasukan yang sesuai tersedia.
Senario yang mungkin termasuk:
- Replika pangkalan data tidak tersedia
- Lambat respon API
- Tamat waktu kebergantungan
- Tekanan memori
- Pengurangan rangkaian
Contoh — Eksperimen Kegagalan Replika Pangkalan Data
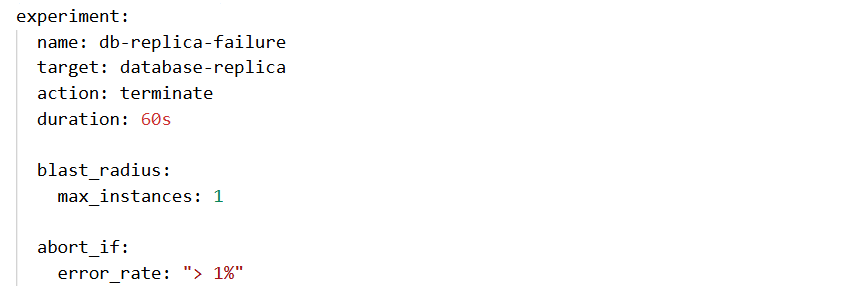
YAML adalah definisi eksperimen ilustratif; pelaksanaan sebenar bergantung kepada platform kekacauan yang digunakan.
Setiap eksperimen memerlukan pembatas: rollback automatik, suis matikan, jejari letupan yang ditetapkan, dan syarat pembatalan yang jelas.
Memasukkan semula insiden ke dalam suite
Setiap insiden penting harus menjawab satu soalan:
Ujian atau pembatas manakah yang sepatutnya mengesan ini lebih awal?
Sebagai contoh, bayangkan insiden pemprosesan pembayaran di mana kegagalan penyedia pembayaran sementara menyebabkan tingkah laku cuba semula yang salah. Insiden diselesaikan, tetapi kerja tidak sepatutnya berakhir di situ.
Ujian regresi seharusnya menghasilkan semula:
- Percubaan pembayaran pertama gagal buat sementara waktu.
- Cubaan semula berlaku.
- Percubaan kedua berjaya.
- Pelanggan melihat satu pembayaran berjaya.
- Pembayaran berganda tidak dicipta.
- Pemantauan mengesahkan tingkah laku dijangka.
Contoh — Dari Insiden ke Ujian
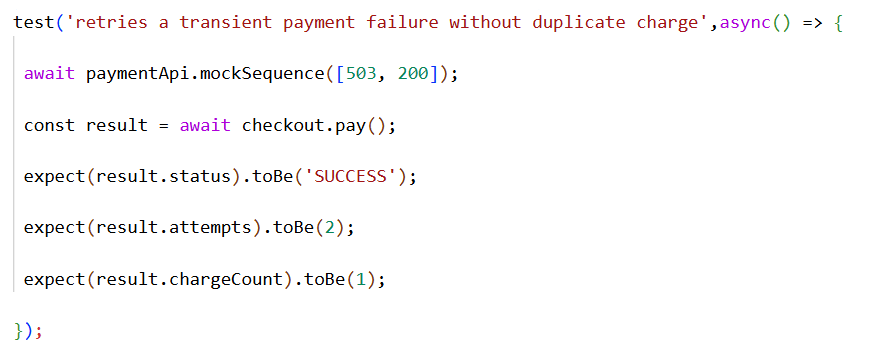
Bahagian penting bukanlah sintaks ujian tepat. Ia adalah gelung maklum balas:
Insiden → Punca akar → Ujian regresi → Peraturan pemantauan → Pembatas masa depan
Alat & pelaksanaan
Ekosistem alat
Tiada satu set pemerhatian yang betul. Pilihan yang tepat bergantung pada skala, infrastruktur sedia ada, kematangan kejuruteraan, dan bajet.
Pemantauan
Datadog
Sesuai apabila pasukan mahukan platform pemerhatian yang diurus dengan integrasi luas dan kurang infrastruktur untuk diselenggara.
Prometheus + Grafana
Pilihan kukuh untuk pasukan yang mahukan fleksibiliti dan asas sumber terbuka serta selesa mengendalikan set pemerhatian tersebut.
New Relic
Berguna untuk pasukan yang mencari platform prestasi aplikasi dan pemerhatian yang bersepadu.
Ujian sintetik
Playwright DIY
Baik apabila QE mahu kawalan maksimum ke atas perjalanan, pernyataan, data ujian, dan integrasi CI/CD.
Pemantauan sintetik diurus
Berguna apabila organisasi mahukan penyelenggaraan operasi yang rendah, pelaksanaan teragih, dan keupayaan pemantauan terbina dalam.
Pengeluaran Canary
Flagger
Berguna untuk penghantaran progresif berorientasikan Kubernetes.
Spinnaker
Platform penghantaran berterusan yang lebih luas untuk organisasi dengan keperluan pengeluaran yang lebih kompleks.
Kontrol pengeluaran asli awan
Sering pilihan paling mudah apabila platform awan sudah menyediakan keupayaan penukaran trafik dan pembatalan yang diperlukan.
Keputusan harus bermula dengan masalah yang hendak diselesaikan, bukan nama alat.
Ingin memahami bagaimana AI mempercepatkan keputusan ini? Dengar podcast kami mengenai Bagaimana AI Membentuk Semula Kejuruteraan Kualiti Moden
Risiko & tadbir urus
Radius letupan
Mulakan dengan peratusan trafik kecil, pembalikan automatik, dan suis hentian.
Integriti data
Transaksi sintetik tidak seharusnya mencemarkan analitik, pemenuhan, pelaporan kewangan, atau data pelanggan. Trafik ujian harus ditanda dengan jelas dan diasingkan.
Keletihan amaran
Pautkan amaran kepada SLO dan impak sebenar pengguna, bukan mencipta amaran untuk setiap turun naik metrik.
Privasi
Telemetri sensitif harus disental, ditokenkan, atau dikecualikan sebelum sampai ke sistem analisis.
Kesiapsiagaan organisasi
QE, pembangunan, dan SRE perlu bersetuju tentang tujuan ujian produksi. Matlamatnya ialah pembelajaran dan ketahanan, bukan menuding jari.
Prasyarat
Sebelum memperkenalkan ujian shift-right secara berskala, saya ingin mempunyai tiga perkara berikut:
- Instrumen — log, metrik, jejak dan telemetri perniagaan yang berguna.
- Budaya tanpa menyalahkan — kejadian diperlakukan sebagai peluang pembelajaran.
- Buku panduan — pasukan tahu apa yang perlu dilakukan apabila eksperimen atau peluncuran melepasi ambang.
Tanpa asas ini, ujian produksi boleh menghasilkan lebih banyak gangguan daripada nilai.
Peta Jalan Pelaksanaan
Bagaimana Saya Akan Bermula
Daripada cuba melaksanakan semuanya sekaligus, saya akan membina keupayaan secara berperingkat setiap bulan.
Bulan 1 — Kebolehlihatan
Pasangkan instrumen pada perjalanan pengguna yang paling penting dan tetapkan metrik asas.
Bulan 2 — Pemantauan Sintetik
Automatkan tiga perjalanan kritikal produksi teratas.
Bulan 3 — SLO
Tentukan sekurang-kurangnya satu SLO yang bermakna dan mulakan penjejakan penggunaan bajet ralat.
Bulan 4 — Canary
Jalankan ujian canary untuk satu perkhidmatan dan automasikan perbandingan antara versi stabil dan canary.
Bulan 5 — Kacau di Persekitaran Staging
Perkenalkan senario kegagalan terkawal di persekitaran staging dan sahkan proses rollback.
Bulan 6 — Kacau di Produksi
Jalankan eksperimen produksi 5% yang dikawal rapi.
Bulan 7+
Normalkan kitaran maklum balas:
Insiden → Ujian → Amaran → Pengawal → Pelancaran yang Lebih Baik
Mengukur kejayaan
Metik Sasaran Enam Bulan
Garis asas tepat akan berbeza mengikut organisasi, tetapi rangka kerja sasaran yang berguna mungkin kelihatan seperti berikut:
Metik | Titik Permulaan | Sasaran Enam Bulan |
MTTD | 15 minit | 2 minit |
MTTR | 45 minit | 12 minit |
Insiden pengeluaran | 8–12/bulan | 3–4/bulan |
Kecacatan terlepas | 5–8/bulan | 1–2/bulan |
Panggilan bertugas | 12–15 | 3–5/minggu |
Angka kurang penting berbanding menetapkan garis asas dan membuktikan bahawa amalan sedang menggerakkannya ke arah yang betul.
Kesimpulan & langkah seterusnya
Pendekatan shift-left adalah penting. Tetapi sistem moden adalah teragih, memerlukan banyak data, dan digunakan dengan cara yang tidak dapat diramalkan sepenuhnya oleh mana-mana pelan ujian.
Ujian berasaskan kebolehamatan meluaskan QE sepanjang kitar hayat keseluruhan. Telemetri pengeluaran membantu menentukan apa yang perlu diuji. Trafik sebenar mengesahkan apa yang tidak dapat sepenuhnya dihasilkan oleh persekitaran pra-pengeluaran. Insiden menjadi ujian regresi, dan ujian itu menjadi panduan untuk pelancaran masa depan.
Matlamatnya bukan untuk mengurangkan ujian sebelum pelancaran.
Ia adalah untuk menghentikan perlakuan seolah-olah pelancaran adalah pengakhiran ujian.
Bagi organisasi kejuruteraan kualiti yang matang, shift-right bukan tentang meletakkan QE dalam konflik dengan SRE atau pembangunan. Ia adalah tentang memberi ketiga-tiga pasukan bukti yang lebih baik mengenai bagaimana sistem berfungsi apabila ia paling penting.
Langkah seterusnya adalah bermula secara kecil: satu perjalanan kritikal, satu SLO, satu pemantauan sintetis, dan satu canary yang dikawal.
Kemudian ukur hasilnya.
Pengeluaran tidak sepatutnya dianggap sebagai tempat di mana ujian berhenti. Dengan kebolehamatan yang betul, panduan, dan budaya, ia boleh menjadi salah satu sumber kecerdasan kualiti yang paling kaya untuk pasukan.
Bersedia untuk membina amalan shift-right secara berskala?
Terokai Perkhidmatan Kejuruteraan Kualiti TO THE NEW untuk sokongan menyeluruh: strategi kebolehamatan, penetapan pemantauan sintetis, definisi SLO, automasi penyebaran canary, dan tadbir urus berterusan.